

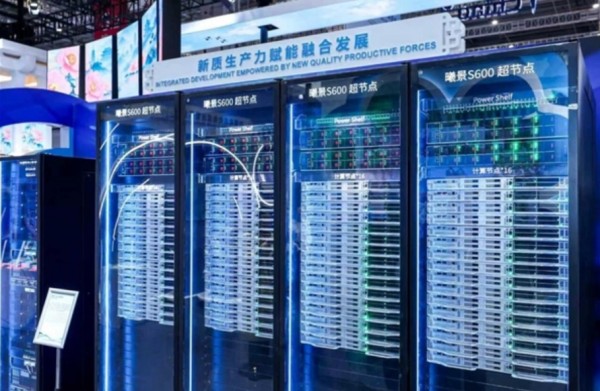
11月6日,第九届中国国际进口博览会在上海举行。沐曦股份作为中国馆唯一入选的国产GPU企业,展出了曦景S600超节点与异构双擎算力机柜,并同步公开了曦景S600的核心参数。在一个长期由国际厂商定义算力标准的场合,“唯一入选”这个身份本身,已经把讨论的起点从“有没有”推到了“到什么水平”。
一颗绑定全国产7nm的GPU
曦景S600的算力单元是沐曦曦云C600 GPU。这颗芯片基于自研XCORE 1.5架构,采用全国产7nm制程,配备144GB HBM3e显存,显存带宽约3.35TB/s。144GB这个数字需要放在参照系里看:英伟达H200的显存规格为141GB,C600在容量上略高于它。显存带宽3.35TB/s同样处在同一量级,这意味着在大模型推理和训练场景中,数据搬运的瓶颈不会被显存带宽过早卡住。
算力指标一侧,C600的FP8峰值算力约1000 TFLOPS,INT8算力达到2000 TOPS,原生支持FP8、FP16、FP32、FP64等多精度混合计算。多精度支持的意义不在于“什么都能算”,而在于同一套硬件可以根据任务类型切换精度模式:训练用FP8/FP16换取吞吐,科学计算用FP64保留精度,推理用INT8压低成本。对于需要在一个集群里同时承载多种负载的客户而言,这种灵活性比单一精度的峰值数字更实用。
“全国产7nm”是C600规格单里最值得单独拎出的一行。它标注的不是制程节点的先进性——7nm在2026年已不是最前沿的数字——而是供应链的完整性。从设计到制造,这条链路不依赖外部先进制程的供给。对于一款面向政企、金融和科研市场的国产GPU而言,供应链的确定性,有时比跑分表上多出的几个百分点更能决定它能否被放进采购清单。
从“一张卡”到“一个机柜”:系统级效率的竞争
单卡规格之外,曦景S600在系统层面的设计,才是这次展出中更具分量的部分。它采用OEX架构,通过正交连接器与两级交换拓扑实现GPU间低时延、高带宽通信。单机柜支持128卡全交换、无带宽收敛,并可通过横向扩展组建万卡级集群。整机采用计算与交换节点零线缆的“三0”设计,机房无需大规模改造即可部署。
这组设计的共同指向是“部署的摩擦系数”。128卡全交换、无带宽收敛,意味着机柜内部的GPU之间不会因为交换层级而出现带宽瓶颈;零线缆设计则把现场施工中最容易出错的环节——线缆敷设与连接——收进了工厂预制环节。对于一个需要快速上线、且机房条件参差不齐的客户现场而言,“无需大规模改造”不是一个便利性描述,而是一道实实在在的部署门槛。
万卡级集群的横向扩展能力,则把竞争维度从“单卡性能”拉到了“集群效率”。在国产算力从“替代”走向“规模化”的阶段,客户真正付费购买的,不是一颗芯片的理论峰值,而是一个机柜、一个集群在真实任务中能稳定交付多少有效算力。曦景S600的系统设计,回答的正是这个问题。
异构双擎:为MoE推理准备的“双芯分治”
与曦景S600同台展出的,还有沐曦与东方算芯联合推出的异构双擎算力机柜。这套方案针对MoE(混合专家)模型的推理场景,采用“双芯分治”:C600承担计算密集型任务,DF1000承担访存密集型任务,目标是同时击穿计算墙与访存墙。
MoE推理的特点在于,模型的不同专家模块被激活的频率和计算特征并不相同:一部分任务需要密集的矩阵运算,另一部分任务则更依赖大容量存储和快速的数据搬运。用同一类芯片去覆盖所有环节,往往会在其中一个方向上出现资源闲置或瓶颈。双芯分治的思路,是用C600的计算密度处理前者,用DF1000的访存能力承接后者,让两种芯片各自跑在更擅长的轨道上。这套方案的实际效果取决于调度层的成熟度,但它所代表的“按任务特征分配异构算力”的方向,正在成为MoE推理基础设施的一种务实解法。
从单卡144GB HBM3e到128卡全交换的系统,再到与东方算芯联合的异构机柜,沐曦在进博会上展出的,不是一个孤立的芯片参数,而是一条从芯片到机柜、从同构到异构的算力交付链路。国产GPU的竞争维度,正在从“谁的芯片规格更高”转向“谁能让一套系统在真实机房里更快跑起来、更稳跑下去”。这个转向是否成立,接下来要看的是量产交付的节奏和客户现场的运行数据。
(素材来自:沐曦股份 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。