11月11日,Anthropic在非交易路演会议上披露了一组此前未公开的数字:其旗舰模型Opus 5.5的整体开发成本超过100亿美元。
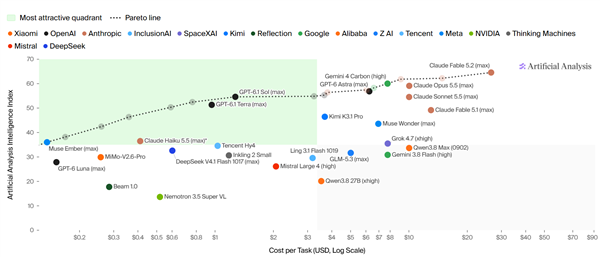
Opus 5.5发布时是全球最强的大模型,近期排名也仅落后于自家规模更高的Fable 5.2。
100亿美元这个量级,放在任何一家公司的研发预算里都不是一个小数目,而它对应的,只是一个模型的开发过程。
10万张B300与“可复用”的算力账本
100亿美元的具体流向,Anthropic没有逐项披露,但从已知的硬件配置可以推算出大头。仅训练所用的10万张B300显卡,采购成本就达到数十亿美元。
需要区分的是“开发成本”与“单次训练成本”:这些显卡并非一次性消耗品,后续可以继续用于其他模型的训练和推理,因此Opus 5.5单次训练的实际费用不可能达到100亿美元。
100亿美元覆盖的是从预训练到后训练、从数据准备到对齐调优的完整链路,以及支撑这条链路持续运转的硬件折旧和基础设施开销。它更像一张“入场券”的价格,而不是一次训练的电费。
国产模型面前的四道坎:算力、参数、节奏与成本
Anthropic的这组数字之所以在中文技术社区引发讨论,是因为它恰好对照出了国产大模型在当前阶段面临的几重结构性约束。
第一道是高端算力的获取。国内能找到B300级别算力资源的渠道有限,价格通常是海外售价的三倍。成本这一关,在起跑线上就已经拉开了差距。
第二道是参数规模。Opus 5.5的参数量被认为在5万亿以上,而国内AI公司目前做到的最高水平是3万亿。经验上足以驾驭再翻一倍参数量的超大规模训练,但需要磨合的地方很多,参数的跨越不是简单的线性放大。
第三道是发布节奏。从7月到现在,国内大模型的发布周期明显慢于海外头部厂商,近期几家发布的多是Flash级别的模型。Kimi K3.1 Pro虽做到了2.8万亿参数,但算力不够,发布没多久声量就淡了下去。
第四道是即将出牌的型号。智谱的GLM-5.5和DeepSeek V4.1 Pro尚未发布,规模预计在1万亿至2万亿参数之间,成本比Opus 5.5小很多,但参数规模的差距意味着性能全面追赶的难度依然存在。
差距不在智慧,在资源的量级
把这几道坎放在一起看,国产AI与前沿模型之间的差距,并不落在研发人员的智慧上。
Anthropic能拿出100亿美元开发一个模型,背后是成熟的算力供应链、可预期的硬件采购通道和资本市场对长期亏损的容忍。
国内公司面对的是三倍溢价的算力、更窄的获取渠道和更紧的预算约束。
在硬件算力和资金相差几个量级的情况下,追赶前沿水平需要的不只是算法的优化,还需要整个基础设施和资本生态的同步跟进。
(素材来自:Anthropic 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。