向漏洞研究的专用AI正式推出
当地时间11月5日,OpenAI对外推出专门用于网络安全研究的GPT‑6Cyber模型。这款模型聚焦软件漏洞查找、有效性验证,还可以辅助生成漏洞利用代码与修复建议,定位是面向安全领域的专项大模型,和面向普通用户的通用对话模型有着明确区别。
相比于上一代GPT‑5.6Cyber,新版本在漏洞利用相关任务上获得不小的能力跃升。但由于该模型具备挖掘高危安全缺陷、生成攻击代码的能力,内部安全评估已经将它划入最高的关键风险等级,高于上一代产品的高风险评级。出于风险管控考量,该模型不会向普通公众开放访问。
基准测试展现性能提升
ExploitGym是行业用来衡量AI漏洞利用水平的测试基准,重点考核模型针对远程漏洞完成利用的综合实力。根据官方公布数据,GPT‑6Cyber在该项测试拿到48.5%的得分,对比GPT‑5.6Cyber的32.1%,实现大约51%的相对性能提升。
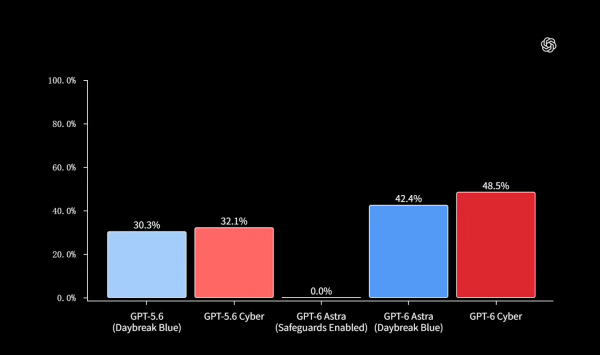
除了攻击能力,模型在遵守任务边界方面同样做了优化。在没有额外配置安全提示的条件下,99.93%的测试案例不会越权攻击任务授权之外的目标服务。如果配套对应的安全提示指令,模型完全不会发生越界行为,越权攻击的案例占比可以降到零。
真实软件项目的漏洞挖掘成果
除了基准测试的纸面分数,OpenAI也把模型投入真实开源软件项目开展安全实验,拿到了大量可供落地的安全发现。
研究团队借助GPT‑6Cyber完成Linux内核漏洞复现工作,总共成功复现1724个内核相关漏洞,并且为其中948个漏洞编写完成可以实际运行的权限提升利用程序。这些结果可以帮助安全团队看清漏洞实际危害,给后续修复工作提供参考依据。
Firefox浏览器的测试案例更受外界关注。这款浏览器经过长年的安全审计,大量人工研究员与自动化工具长期对代码库开展扫描。即便如此,GPT‑6Cyber依旧找到了81个过去没有被外界知晓的高危漏洞。
研究人员同步向Mozilla提交漏洞详情、复现用例,同时附带候选补丁方案。Mozilla收到报告之后已经启动修复流程,相关安全更新已经逐步面向浏览器用户推送。
严格的访问限制与安全管控机制
因为模型能力具备较高安全风险,GPT‑6Cyber初期只面向经过完整资质审核的DaybreakRed客户开放使用,不会对外开放。
调用该模型的同时会启用一整套配套防护手段,包含滥用行为实时监测、凭据信息保护、沙箱隔离环境、人工审核监督,还会专门拦截针对关键基础设施发起的各类高风险操作,尽可能降低模型被恶意使用带来的隐患。
OpenAI表示,AI辅助软件安全已经来到重要发展窗口。后续会逐步拓宽Daybreak计划的覆盖范围,希望未来可以让更多企业机构、独立安全研究者、开源项目维护人员,借助这套AI工具开展代码审计、漏洞排查和补丁开发工作,以此改善大量开源软件的整体安全水平。
(素材来自:OpenAI 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。