

一次普通设备研究,意外引发账号封禁风波
近期海外科技圈出现一桩颇具争议的事件,一名安全领域研究者,针对自己花钱购入的三星智能电视开展本地逆向分析,在对外公布隐私相关调研结论之后,他的OpenAI账号遭到平台封禁,这件事也在安全从业者群体当中引发大量讨论。
这名研究者手中是一台2025款三星智能电视,日常使用过程中,设备频繁推送高度匹配个人习惯的定向广告,这让他产生好奇,想要摸清Tizen系统内部的数据采集逻辑。电视固件采用AES加密保护,他借助系统漏洞拿到设备Root权限,在本地环境对电视系统内部各项功能做拆解分析。
经过解析,他发现这套电视系统内置自动内容识别ACR、音频事件识别、设备信息采集、广告追踪等多项模块。系统能够识别环境当中狗叫、婴儿啼哭这类声音事件,同时还会利用设备专属标识,串联起用户的各类行为数据,相关监测行为会生成日志回传给厂商。研究者把整套观测结果对外公开发布,分享智能电视隐私收集方面的细节。
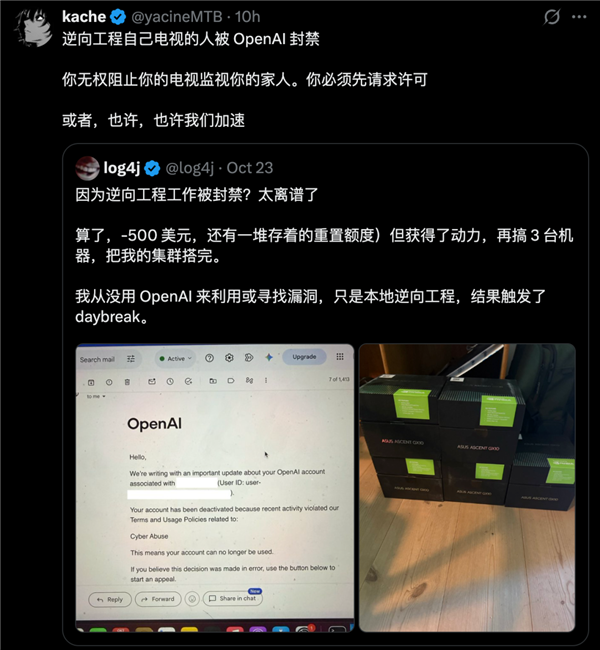
公开研究成果42小时后,账号被判定网络滥用
距离这份研究内容对外发布大约42小时,该研究者收到OpenAI的账号处置通知,平台给出的封禁归类为Cyber Abuse也就是网络滥用。账号封禁之后,他直接损失账户内价值500美元的可用额度。
按照这名研究者的说法,整个逆向分析全程只在自己的本地硬件设备上完成,从来没有调用OpenAI的服务去攻击外部系统,也没有借助AI工具挖掘漏洞,仅仅是做消费设备的安全调研,却触发平台风控机制。他表示并没有预料到本地硬件逆向行为,会间接导致自己的AI账号无法继续使用。事件曝光之后,不少技术从业者提出疑问,用户对自己合法购置的硬件做逆向研究,是否会被AI平台风控系统误判为恶意行为。
Claude同样出现逆向任务拦截现象
几乎同一时期,Anthropic旗下的Claude模型也出现相似的情况,再度把AI工具与逆向工程之间的矛盾摆上台面。有开发者在Reddit社区发帖反馈,使用Claude Opus5.5搭配REA逆向工程工具生成技术文档的时候,模型会在输出中途启动安全校验,直接终止内容输出。
即便开发者调整提问措辞,尝试绕开限制,依旧无法获取完整的逆向分析材料。模型给出提示,安全分类器拦截了本次任务,就算重新发起相同请求,也不能绕过这套防护机制。不少开发者实测之后确认,模型针对逆向类任务的约束已经生效,相关能力被悄悄收紧,厂商没有对外发布正式更新公告。
AI安全护栏,面临区分合法研究与恶意攻击难题
接连发生的两起案例,折射出当下AI服务商的现实困境。随着大模型越来越多地参与漏洞挖掘、软件解析、硬件改造等技术工作,平台的安全防护系统需要去分辨哪些属于合规安全研究,哪些属于潜在网络攻击行为。
对于AI厂商而言,设置安全围栏的初衷,是防止模型被利用生成攻击代码、破解方案,降低网络安全风险。但现实场景十分复杂,很多正规安全研究者,也会把AI作为辅助工具,开展设备逆向、漏洞分析,以此发现消费产品的隐私缺陷,推动厂商优化产品。
风控系统依靠关键词、任务类型做识别,很容易出现误判。一边是防范网络威胁的责任,一边又不能一刀切扼杀正常安全调研,两者之间的平衡,已经成为各大AI企业需要持续打磨的课题。
整个行业还没有形成统一清晰的判定标准,如何给安全研究留出合理空间,避免合规研究者无辜受限,也会成为后续AI安全规则完善过程中需要重点探讨的方向。
(智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。