

8月26日晚间,阿里巴巴通义千问团队正式发布并开源了最新大模型Qwen3.8-Flash及其开源权重版本Qwen3.8-Flash-Next。后者是Qwen4系列模型的架构预览版,采用与此前所有千问大模型完全不同的全新设计。
Qwen3.8-Flash-Next是一个多模态混合专家(MoE)模型。主模型参数量为125B,额外配备51B的N-gram Embedding参数,每次token仅激活6B参数。模型原生支持262,144 token的上下文窗口,可通过YaRN扩展至1M token。
架构层面,模型共48层,包含36层Gated DeltaNet线性注意力层和12层Qwen稀疏注意力(QSA)层。QSA机制与GDN高效融合,在高缓存命中的1M token长上下文实际场景中可提速8倍以上。
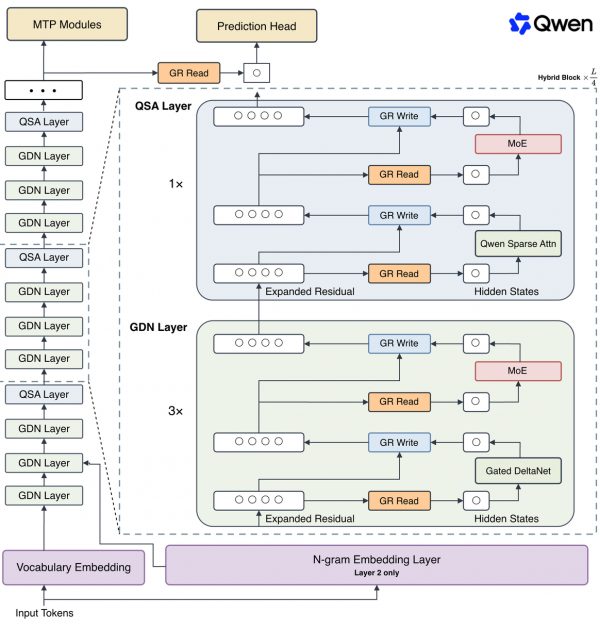
模型结构
性能方面,千问团队公布的基准测试结果显示,Qwen3.8-Flash-Next在智能体、编程、通用能力以及多模态等绝大多数测试中都超越了Qwen3.8-27B、Qwen3.7-Plus、DeepSeek-V4-Flash-0731和Claude Opus 4.6(Max)。
在具体评测中,DeepSWE 1.1达到58.7,SWE-bench Pro达到62.5,LiveCodeBench v6达到91.9。尽管属于Flash定位的中端效率优先版本,它在多数基准上仍胜过Claude Opus 4.6 Max。BenchmarkList的综合评测数据显示,Qwen3.8-Flash-Next在226个模型中排名第25位,智能体能力排名第13位(138个模型中),指令遵循能力排名第5位(42个模型中)。
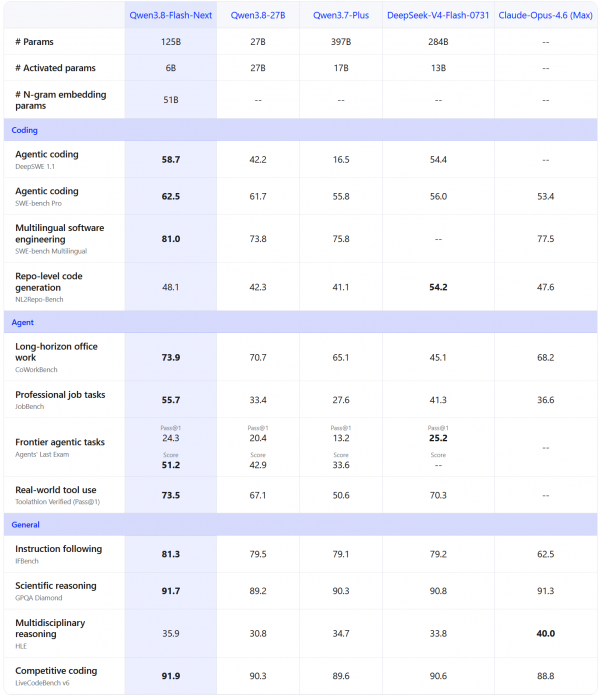
纯文本性能
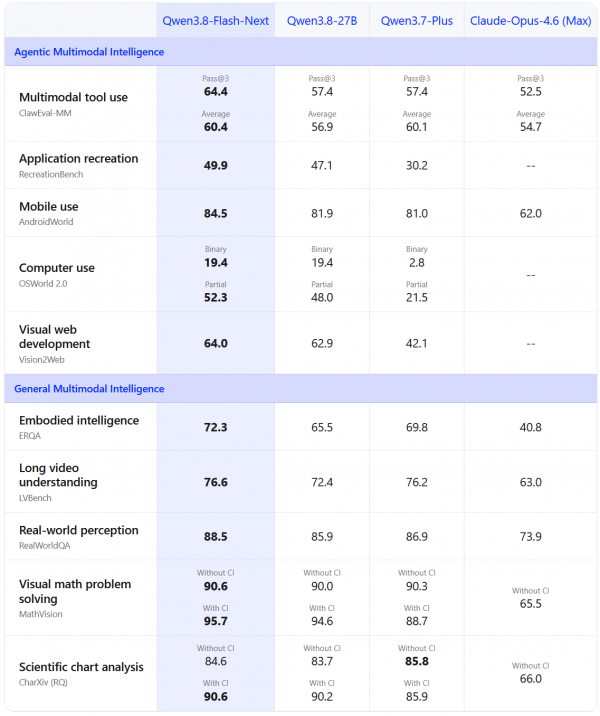
多模态性能
训练和推理成本的降低是此次发布的一大亮点。得益于架构和训练的全面革新,Qwen3.8-Flash的训练成本较Qwen3.7-Plus下降近90%(约为前者的九分之一),推理成本同步大幅下降。在千问AI平台上,Qwen3.8-Flash的API定价为每百万token输入1元、输出3元。以美元计价,生产版Qwen3.8-Flash通过QwenCloud提供API服务,定价为每百万输入token 0.16美元、每百万输出token 0.47美元。这一价格相比DeepSeek-V4-Flash空闲时段的价格低约33%。
需要说明的是,Qwen3.8-Flash与Qwen3.8-Flash-Next指向同一模型的不同版本——前者是API服务名称,后者是开源权重的正式名称。目前,Qwen3.8-Flash-Next的模型权重已在Hugging Face和魔搭社区(ModelScope)全面开源。Qwen AI平台支持兼容OpenAI的Chat Completions和Responses API,以及兼容Anthropic的接口,可直接配合Claude Code、Codex等工具使用。
市场反应方面,阿里巴巴美股(BABA)在消息公布后上涨约2%。开发者社区反响热烈,消息在Hacker News等平台迅速刷屏。有海外开发者评论称“这太强了”、“我们不需要OpenAI”、“Qwen未来有可能超越Opus”。Gartner分析师Arun Chandrasekaran表示,阿里将Qwen3.8-Flash-Next定位为适用于广泛企业工作负载的主力模型,在工具调用和编程等Agentic应用场景中极具竞争力。
此次发布正值阿里加码AI投入的关键节点。本周一,阿里刚刚发布了视频生成大模型Wan3.0。公司近期宣布规模8000亿港元的股权融资,资金将投向全栈AI能力建设和AI基础设施扩充。联合创始人马云近期斥资超6亿港元增持港股。Qwen模型全球下载量已突破30亿次,衍生模型数超30万个。
( 素材来自: 阿里巴巴 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。