

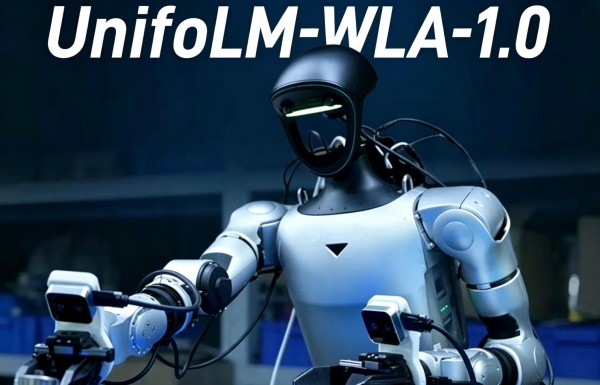
近日,宇树科技宣布完全开源新一代通用人形机器人基础模型UnifoLM-WLA-1.0,代码、模型权重和数据集同步开放。目前项目主页已上线,Code、Models和Datasets等资源正在陆续发布中。
这是一款参数量为60亿(6B)的具身智能模型。官方介绍称,该模型基于约2500小时高质量真机数据训练,配套超过500万条训练样本,数据涵盖宇树自有开源数据与BitRobot-HIW-500等公开资源。一套模型即可驱动机器人完成64项操作任务,包括10项全身移动操作和54项桌面精细操作。
具体任务场景覆盖广泛。全身操作方面,机器人可以倒垃圾、把衣服放进洗衣机、整理鞋子、收拾浴室和厨房、铺床、取蔬菜、整理沙发。桌面操作方面,则包括叠毛巾、叠衣服、收纳餐盘、电池充电等。
不再“各管各的”:单模型统筹手和身体
UnifoLM-WLA-1.0的核心突破,在于把双臂协作和全身操作纳入了同一套模型。
以往不少机器人操作模型主要关注机械臂和末端执行器,比如抓取、放置、整理物品。但当任务从桌面走向真实家庭环境,机器人往往需要同时移动身体、调整姿态,再配合双臂完成操作。
在宇树给出的案例中,搭载该模型的机器人可以同时调动双臂、末端执行器和下半身,完成需要全身协同的任务。比如整理鞋子和厨房时,涉及更大空间范围内的移动和连续操作;铺床等任务中,双臂动作也需要与身体姿态密切配合。
这套模型并未绑定单一末端执行器,可同时适配平行夹爪和两种灵巧手。宇树为此建立了一套统一动作空间,将机器人动作拆分为末端执行器位姿、末端执行器关节和下半身关节三部分,再通过残差向量量化模型将连续动作转化为离散Token。不同身体部分的Token按照共享时间步对齐后送入模型,从而学习手、末端执行器和下半身之间的协同关系。
先预测“哪里会变”,再动手
UnifoLM-WLA-1.0的另一个特别之处,在于将交互后的场景变化也纳入了模型训练。
宇树将这类信息称为“动态区域”。模型首先利用光流从前后视频帧中提取发生变化的区域,再通过VQ-VAE将这些连续变化压缩为固定长度的离散Token。之后,模型只需看到当前图像加上任务描述或动作条件,就可以预测未来哪些区域可能发生变化。
这意味着模型学习的内容不再局限于“现在画面里有什么”,还包括“如果执行这个动作,接下来哪里可能发生变化”。
宇树将这一体系概括为“具身推理+未来变化预测+动作学习”——机器人既要理解当前看到的空间和物体,也要预测一次交互可能让场景中的什么地方发生变化,随后再生成具体动作。
用一句话来概括就是:理解世界,并将理解连接到行动。
技术底座与评测表现
据品玩报道,该模型采用三阶段架构,融合视觉理解与物理预测,通过MMDiT解码器生成平滑轨迹。技术路线上,模型基于UnifoLM-ER-Flow多模态主干网络,搭配MMDiT动作专家模块。
在多项具身推理评测中,UnifoLM-WLA-1.0刷新了全球开源模型的SOTA。据官方数据,其核心推理模型在空间规划任务EGO-PLAN2中得分55.1,而RoboBrain2.0-7B仅为33.23;在空间指代理解REF-SPATIAL上得分61.7。
报道称,该模型在7项评测中领先全球开源模型。
宇树的“世界模型”路线
UnifoLM-WLA-1.0的发布,是宇树在世界模型路线上持续布局的最新一步。就在几天前的9月7日,宇树刚刚发布了世界-动作大模型UnifoLM-X2-1.0,首次实现由世界模型实时驱动的全自主人形机器人格斗。
视频中,机器人全程脱离人类遥控,自主完成了格斗中的各项动态交互。宇树方面称,该模型突破了瞬时规划、决策和动态交互执行等瓶颈。
从X2-1.0到WLA-1.0,宇树的技术演进路径逐渐清晰:先在高动态、强交互场景中验证世界模型的实时决策能力,再将这种能力拓展到更广泛的桌面和全身操作任务中。
宇树科技CEO王兴兴指出,物理接触存在偏差,行业仍需突破;此次开源旨在降低算法部署门槛,推动具身智能技术从实验室走向实际应用。
(素材来自:宇树科技 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。