

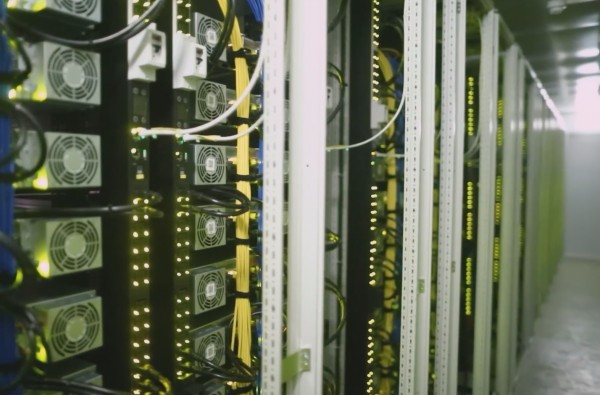
随着AI机架功率突破100kW,电气工程和韧性规划——而非芯片数量——正在设定上限。
几十年来,每一代新硬件都在更小的空间内集成了更多的计算能力。AI将这一趋势加速到了数据中心前所未有的速度,运营商试图在AI工厂部署中从每个机架榨取最大性能。变化是巨大的。两年前看似极端的机架现在已司空见惯,而下一次跃升已经在建设图纸上。
数据说明了问题。一个常见的基准是“模态机架密度”,即每个机架最常见的报告功率消耗。根据Uptime Institute的第16次年度全球数据中心调查,2026年这一数字达到了11kW,高于2025年的9kW。
11kW的描述只适用于典型的企业服务器机房——你如今在大多数数据中心实际会经过的那种——而非AI训练集群。AI机架完全属于完全不同的功率等级。
Nvidia的GB300 NVL72——在2025年和2026年初是AI训练集群的核心——根据Nvidia的NVL72 AI工厂参考架构,每个机架需要高达142kW。Nvidia的最新平台Vera Rubin NVL72已于2026年6月进入全面生产,并计划于今年秋季向云提供商发货。虽然Nvidia尚未公布官方机架功率数据,但行业媒体报道将其定在190kW至230kW之间。在其之后,Nvidia的Rubin Ultra NVL576“Kyber”机架在2027年下半年已被明确规格为约600kW。
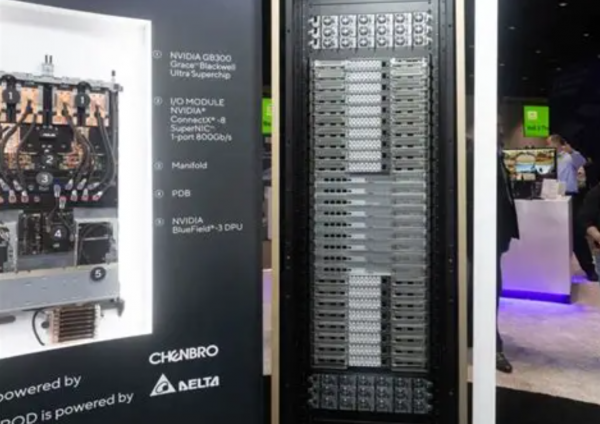
Nvidia的GB300 NVL72机架平台
那么,真正限制密度的是什么?
三个问题定义了上限:机架能移除多少热量、芯片消耗多少功率、以及设施能安全输送多少功率。
问题不在于芯片数量,也不是靠更大风扇就能解决的。“关于限制密度的最大误解是,它受限于每个机箱的GPU数量,或者这是一个可以通过更大风扇解决的冷却问题,”eRacks Systems创始人兼首席技术官Joseph Wolff分析道。
风冷已达到极限,液冷已接管
更多的计算意味着更多的热量,多年来,热量移除一直是密度的硬性限制。随着冷却技术的改进,这一限制不断被打破。
根据Uptime Institute的说法,风冷在每机架大约50kW以上变得不切实际。超过那个点,风扇就无法移动足够的空气来跟上热负荷。
直接芯片冷却现已成为标准
通过芯片上的冷板输送的液体现在可处理每机架100至150kW,并已成为主导的液体冷却方法,根据施耐德电气的数据,截至2026年占据55%的市场份额。
两相浸没式冷却正在复苏,而非消亡
曾被誉为终极方案的两相浸没式冷却,在PFAS限制切断了冷却液供应后受到打击。采用率尚未完全恢复。一种替代流体在2026年初获得认证,尽管监管结果要到2027年才能解决。
“微流体是我仍会称之为‘路线图讨论’的技术。科学原理已得到验证,但主流部署仍需数年时间,”IBM多供应商支持服务副总裁Omkar Nimbalkar在接受采访时表示。
下一步散热会深入芯片内部
2025年9月,微软和瑞士初创公司Corintis报告了实验室测试,显示直接蚀刻到芯片中的微通道可以比标准冷板更有效地移除热量,效果高达三倍。
电力输送,而非冷却,设定了真正的上限
热物理不是唯一的约束。电力输送同样具有约束力,而最终决定限制的并非芯片规格。“人们根据芯片规格来基准测试密度,而实际上,它受到电气工程和故障规划的约束,”Nimbalkar说。
传统的54VDC电力分配在每机架大约200kW以上会遇到硬性限制,此时承载该电流所需的铜变得太粗、太重且难以构建。
冗余会施加过多成本
Nimbalkar指出,一个典型的配电单元处理约20kW,采用双冗余配置,而服务器每台最多消耗6kW。“设计问题从来不是你能买多少GPU,而是如果电源发生故障,你能安全运行多少,”他说。
电源馈送,而非芯片,最终设定限制
芯片供应商已经在围绕这些约束进行设计,以不同的功率水平提供相同的GPU以适应实际的功率范围。“真正的限制是每个机箱的功率和热预算,而这由GPU本身设定,”Wolff说。
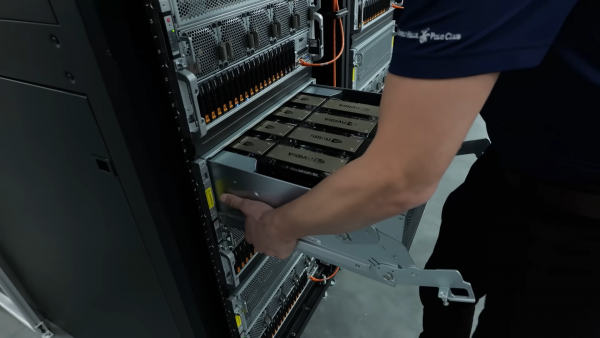
“Nvidia将相同的96GB RTX PRO 6000 Blackwell作为600W部件和300W Max-Q部件销售——第二个SKU的存在是因为八张600W的卡放在一个4U机箱中是一个5kW级别的热问题,大多数风冷机房无法提供或排出,”他说。
解决方案正在从试点走向标准
多项努力正在进行中,以缩小机架需求与设施可提供的功率之间的差距。
更高电压的直流配电正在超越试点
Vera Rubin NVL72已经采用800VDC发货。过渡已经超越了试点阶段:Vertiv、施耐德电气、伊顿和台达都计划在2026年下半年推出商用800VDC产品,富士康在台湾的40MW高雄一号设施正是为此而建。
但硬件可用性并不等同于广泛采用。“最终,我们要让构架在18到24个月内消化一个代际的变化量,”Flex嵌入式和关键电力业务总裁Chris Butler说道。
电力输送正在从计算机架中解耦
开放计算项目的Mount Diablo项目在2026年3月达成了最终化的0.7.0规范;微软和Meta在2026年7月展示了基于该规范的工作硬件。通过将电力输送与计算分离,设施可以独立于其所供电的机架来扩展电力。
现场和表后发电正在获得越来越多的关注
越来越多的运营商正在建设自己的电力容量,而不是等待公用事业公司的时间表。园区层面“纸面上的”功率并不能保证你能可靠地将其输送到单个机架。
“一旦你开始以这些密度运行,配电和冷却真的必须协同工作,所以我更关注的数据不一定是园区纸面上有多少兆瓦,”Axe Compute首席执行官Christopher Miglino在接受采访时说。“而是你能实际输送、冷却和可靠运行多少功率,”他说。
未来三到五年的上限可能在哪里
热量移除、电力输送、故障风险和成本,每一个都在未来三到五年内面临一个悬而未决的问题。这四个因素共同决定了未来“典型”数据库中心的样子。
电网,而非机架,将起决定性作用
电力可用性将是决定性的。截至2025年底,超过2060GW的发电和储能正在美国的并网队列中等待,数据来自于劳伦斯伯克利国家实验室的Queued Up报告。
“现场发电更依赖于具体项目,但它正在成为超大规模AI园区讨论中更重要的部分,因为在许多市场中,约束不是需求或GPU的获取——而是你能多快从电网获得足够的电力,”Miglino说。
随着机架变得更加密集,故障代价更高
随着密度攀升,单次故障造成的计算损失比以前更大。这提高了检测和优雅降级的要求。“更聪明的方法是在固件级别构建故障检测,可以在几秒钟内降低机架功率,这允许你比保守的静态数字通常允许的密度运行得更高,”Nimbalkar说。
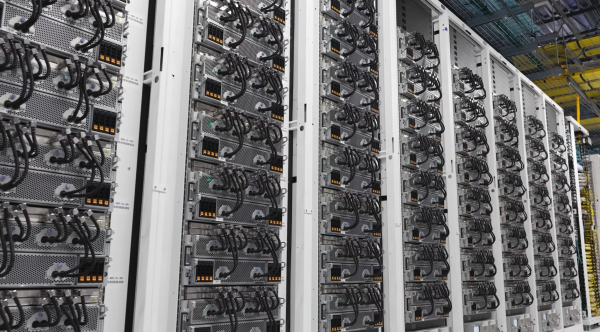
到2028年,典型的高密度机架可能超过100kW
最可能的默认值是每个机架100kW或更多。
“2028年典型的高密度AI机架可能是100kW以上的部署,直接液冷成为标准,400V电力输送,故障处理逻辑内置于固件中而非事后添加,”Nimbalkar说。
Miglino预计同样的阈值,领先者的密度将远远超过它。然而,Wolff预计会出现分化:大多数企业将保持风冷,而一小部分头部机架将远远超过100kW。
“典型的高密度AI机架——大多数企业实际将部署的——是风冷4U节点,每节点八张300W级别的GPU,每箱约4kW,每个机架三到四个箱体,使用普通的208V供电*,”Wolff说。
*美工工业用电电压标准为三相208V
(全球储能网、新能源网、智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。