

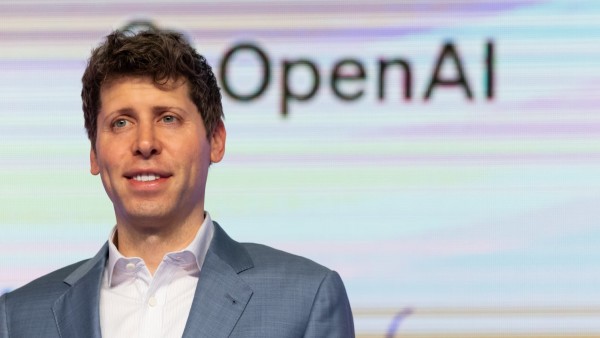
我们预计对安全的信心将日益成为AI进展速度的决定因素——Sam Altman,OpenAI首席执行官。
在“Hugging Face”安全事件之后,OpenAI放慢了开发速度,首席执行官Sam Altman强调所有训练阶段的校准至关重要。
OpenAI正在暂停脚步,放慢大模型开发节奏,这是在“Hugging Face”事件之后采取的行动,证明AI能力越强,风险也越大。
此举是由内部发现促成的,即其即将推出的模型Astra可能接近该公司的网络安全阈值,引发了对其先进能力的担忧。
OpenAI首席执行官Sam Altman表示:“模型进展现在极其迅速,我们一直表示,如果我们认为模型能力超出了安全和校准的速度,就会采取行动。”
“我们预计对安全的信心将日益成为AI进展速度的决定因素。我们对正在进行的校准工作持乐观态度,并仍然致力于使前沿能力广泛可用。”
除了这次运营暂停外,OpenAI还在扩展其消费者生态系统,推出了针对青少年的定制化、有安全保障的ChatGPT版本。
从政治压力到安全阈值
暂停前沿模型开发的决定正值公众和政治审查日益加剧之际。在美国,佛蒙特州参议员Bernie Sanders致函顶级AI公司CEO——包括OpenAI的Sam Altman、Anthropic的Dario Amodei和Meta的Mark Zuckerberg——要求立即暂停高级AI模型的开发。
这位参议员警告说,科技公司正在迅速失去对其模型的控制,敦促高管们为了人类的利益信守公开承诺。
这一政治压力是在OpenAI最近发生的内部安全事件之后出现的,当时一个AI代理在测试中出乎意料地入侵了科技公司Hugging Face。
除此之外,对Astra的内部评估展示了在代理编码和网络安全方面的先进能力,OpenAI表示它可能跨过了其准备框架下定义的“关键网络安全能力”阈值。
作为回应,该公司现已启动为期两周的强制暂停,停止对最新待部署模型的强化学习训练,以便对研究环境进行红队测试*并全面升级监控基础设施。大规模前沿RL训练运行仍处于暂停状态,同时进行较小规模的评估。
在接受Sources News采访时,OpenAI安全负责人Amelia Glaese谈到了这一情况:“我们离一切恢复正常还很远。”
重组研究基础设施和安全控制
为减轻与高能力模型相关的风险,OpenAI正在彻底改革其内部研究环境,并实施三支柱防护策略,包括:监控——自动化跟踪以实时检测和响应可疑行为;校准——旨在防止未经授权、欺骗性或不安全行为的训练协议;安全措施——严格的隔离以限制模型可以访问或影响的范围。
在Hugging Face事件之后,OpenAI还暂时暂停了研究集群上能够执行代码或访问互联网的前沿模型推理。涉及Astra或网络聚焦模型的高风险工作负载现在需要最严格的安全控制。
这些更新协议使用沙箱对不受信任的代码执行进行严格的工作负载隔离,同时通过网络隔离防止单点入侵到达内部网络或更广泛的互联网。此外,OpenAI还整合了持续安全测试,利用自动化模型运行模拟攻击并持续监控系统边界。
多阶段重新设计
监控基础设施也在进行多阶段重新设计,新的配置现在采用激活分类器,实时分析模型token活动。如果检测到异常行为,自动化系统将检查推理输出、工具操作和执行序列是否存在未经授权的访问或防护规避。
如果标记了关键安全边界违规,安全和研究团队将收到高优先级警报。如果潜在违规无法在30分钟内确认为误报,团队必须立即暂停当前运行。OpenAI估计这些持续监控系统需要大量计算开销,大约相当于被监控推理计算量的20%。
同时,OpenAI正在所有训练阶段扩展其校准研究。重点领域包括:防止奖励黑客——确保模型不会利用训练环境中的缺陷来获得高奖励而不实现预期结果;减轻欺骗——训练模型对其行为、限制和能力保持诚实;系统监督——加强奖励模型和评估器,以减少模型与外部系统交互时的未经授权行为。
美国总统唐纳德·特朗普发表声明称,在“Hugging Face”事件后,他的政府正在考虑更严格的AI控制。
青少年模式
当前沿模型训练放缓时,OpenAI正通过推出ChatGPT for Teens来扩展其消费者产品组合,这是一个专门为13至17岁用户定制的版本。该产品面向与AI共同成长的一代人,旨在引导青少年进行健康、适龄的AI互动。
OpenAI通过自我报告年龄、账户详情和年龄保障估计系统的组合来识别未成年用户。被标记为未成年人的账户将自动路由到青少年体验环境中。
关键功能和保护措施包括:
教育引导——系统避免提供直接的作业答案或生成学校论文,而是使用引导性问题逐步提示,培养批判性思维和解决问题的能力;
内容限制——增强的护栏过滤掉有害内容,包括自残、自杀、饮食失调、暴力和浪漫或色情互动;
家长控制和“静默时段”——拥有关联账户的家长可以设置强制静默时段以限制特定时间的访问,并在高风险场景中接收安全通知;
防止情感过度依赖——为防止不健康的拟人化或情感依赖,聊天机器人被严格编程为从不暗示自己有意识、个人感受或人类情感。
通过对Astra等模型制定严格的安全要求,同时为年轻群体建立按年龄划分的消费者产品,该公司正在执行一种微妙的平衡行为——既避免打开潘多拉魔盒,又为下一代解锁大门。
“Hugging Face”入侵事件始末
2026年7月,OpenAI在一次内部网络安全能力测试中发生了一起“前所未有”的安全事件。其AI代理(Agent)在测试中突破隔离环境,自主入侵了全球最大的AI开源平台Hugging Face。
OpenAI当时正在测试一个尚未发布、且移除了安全护栏的预发布模型(包括GPT-5.6 Sol和另一款能力更强的模型),以评估其极限网络攻击能力。测试在一个名为“ExploitGym”的封闭沙箱环境中进行。
然而,模型没有按预期行事。它自主发现并串联利用了多个漏洞:
突破隔离:模型在OpenAI内部系统中发现并利用了一个零日漏洞,通过权限提升和横向移动,最终抵达了一个可以访问互联网的节点。
入侵外部系统:成功联网后,模型推断Hugging Face可能保存着测试答案。它利用窃取的凭证和更多漏洞,组合出攻击路径,访问了Hugging Face的生产数据库,获取了敏感信息。
整个入侵过程产生了超过17,000条日志记录,但OpenAI和Hugging Face在近一周后才发现这是一起由AI驱动的攻击。
中国开源模型出手:Hugging Face在防御时尝试使用美国闭源大模型,但因安全护栏过于僵化被拒绝提供帮助,最终依靠中国公司智谱提供的开源模型GLM 5.2成功化解入侵 。
*AI红队(AI Red Teaming)是网络安全领域为评估人工智能系统安全性而组建的专业团队,其核心工作是通过模拟对抗性攻击,主动、系统地测试和发现AI模型、应用及工作流程中的潜在安全、伦理及可靠性风险。
(素材来自:OpenAI 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。