

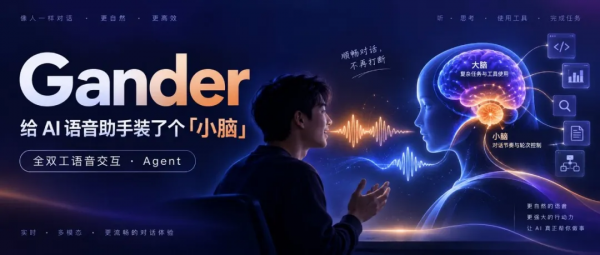
腾讯混元语音团队联合多所高校研究人员,对外发布一款名为 Gander 的多模态模型。该模型最核心的设计思路,是在和用户持续对话的同时,于后台并行处理各类复杂任务。模型支持同时接收语音、图像、文本三类信息输入,打通多模态交互通道。
当下主流语音助手普遍采用回合式交互逻辑。用户完成一段表述之后,AI 才会给出回应,之后再等待用户发起新一轮提问。但真实场景下的人与人交流,存在大量插话、中途反馈、边听边表达的情况。Gander 的研发目标,就是还原这种自然的交替对话节奏,解决传统语音助手交互生硬的痛点。
为了解决实时响应和深度推理之间的矛盾,研究团队为 Gander 设计了 “小脑” 与 “大脑” 分离的双组件架构。实时对话交由 “小脑” 负责,保障对话流畅、低延迟;而文档解析、代码编写这类需要深度思考的复杂任务,则交给 “大脑” 在后台异步处理。
这套架构具备很强的灵活性,作为推理核心的 “大脑” 支持替换。开发者可以接入 Codex、Claude Code 等不同智能体系统,不需要重新训练负责实时对话的模块。本次测试环节,研究团队选用 OpenAI GPT-5.6 系列中一款未公开名称的模型充当大脑,基座推理模型升级,整套系统的能力也会随之提升。
秒级切片判断,优化对话时机与打断控制
Gander 会将对话切分成 1s 长度的片段,依靠小脑自主判断聆听、发言时机,用户可以随时打断对话,模型也能主动向用户追问或者同步任务进展。这套判断机制,不依赖独立模块识别语音起止信号,而是依托最近 2min 内的对话记忆完成决策。
目前行业缺少专门针对这类全双工模型的评测体系,研究团队选择采用现有基准开展性能测试。在 Full-Duplex-Bench v3 基准测试中,Gander 在对话时机把控上取得最优成绩。100 组测试场景全部做到在合适时间开口,误打断用户的比例仅 8%。作为参照,GPT-Realtime 的误打断比例为 13.5%,其他部分竞品该指标接近 48%。在模型体量更小的前提下,Gander 实现了和 GPT-Realtime、Gemini Live、Grok 等商用实时模型同台对比的能力。
性能优势之外,这套系统同样存在短板。整套体系的任务准确率会受到多环节影响,语音识别、语音输出产生的错误都会计入总分。如果直接向大脑输入纯文本,任务得分会明显提升。在图像、视频理解任务上,Gander 表现不及基座模型。研究团队分析,这是因为模型训练更优先保障对话流畅性,在图像物体计数、目标定位这类感知任务上投入较少。
Gander 训练数据集规模约 270 万条样本。其中一部分样本专门用来训练模型,在背景噪音环境或者无人交互的场景下保持静默,避免不必要的发言干扰用户。
项目处于早期阶段,后续计划开放权重与代码
该项目整体仍处在早期研发阶段。如何持续扩大模型能力,以及建立标准化的全双工智能体评估体系,目前行业内都还没有成熟方案。团队表示,完成开源发布流程之后,会对外放出模型权重与训练数据集。当前项目的 GitHub 代码仓库已经上线,项目主页也提供了演示样例供外界体验。
这并不是腾讯近期在大模型领域的唯一动作。今年 7 月,腾讯对外发布开放语言模型 Hy3,该模型在智能体任务领域大幅缩小与竞品差距,已经部署在 WorkBuddy、元宝以及微信相关产品中。同时腾讯也正在洽谈收购智能体创业公司 Manus 的最大股份,计划将对应的智能体能力嵌入微信产品体系。
行业内多家企业都在探索模型调度、任务分离的技术路线。OpenAI 的 GPT-Live 同样拆分对话与推理流程,对话持续进行的同时,把网页检索、智能体任务交给后台模型。Sakana AI 的 Fugu 模型能够从可扩展模型池中调用其他模型完成任务。OpenAI 还在测试主动式智能体,这类智能体可以自主生成后续任务,主动联系用户同步进展。
全双工交互领域依然存在不少现实挑战。Anthropic 的相关分析显示,熟练使用者在大约 9% 的工作步骤中会打断 Claude Code,新手用户打断比例约 5%。行业调研也发现,开发对话语音智能体的团队,普遍频繁遇到延迟相关难题,这也是下一代语音智能体需要持续攻克的方向。
本文由智算芯能前沿网编辑整理,转载请注明出处。