

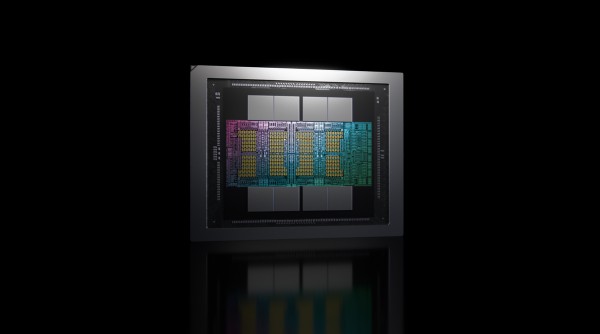
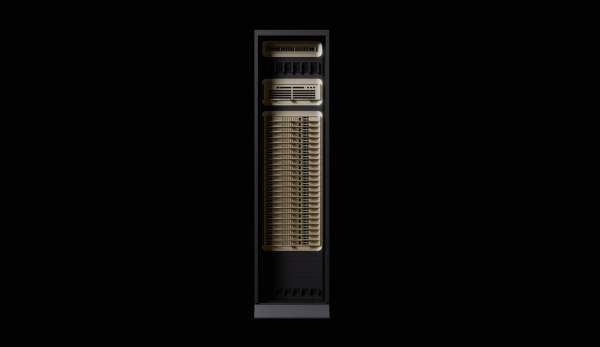
在芝加哥举行的SC26超级计算大会上,英伟达把Vera Rubin平台的两块拼图分别推到了台前。一块是Rubin HPC GPU,单颗芯片集成超过5万个CUDA核心,创下英伟达已公布GPU的核心数量纪录,预计2028年上市。另一块是Vera CPU机架级平台,每颗CPU搭载88个英伟达自研Olympus核心,一个液冷机架塞进192颗CPU、约300TB内存和1PB存储,2027年初由戴尔、HPE、联想和超微开始供货。
两者一前一后,指向同一个目标:让AI智能体在科学发现的工作流里跑得更快,而不是让科学家自己去适应机器。
Rubin HPC:核多是结果,数据跟得上才是目的
“超过5万个CUDA核心”放在标题里足够震撼,但英伟达对Rubin HPC的定位解释得很具体:科学计算的工作负载有一个反复出现的形状——从巨大的数据集里取出零散的数值,算一个结果,再在极大的规模上重复这个过程。稀疏矩阵运算、模板计算、排序和归约,这些模式横跨气候模拟、工程仿真、基因组分析和金融风险建模。核心再多,如果数据供不上,算力就是在空转。
Rubin HPC的应对方式是“平衡设计”:同时扩展数据移动和计算能力,而不是只堆计算。它引入的稀疏数据加速能力,目的就是把那些不规则、稀疏的数据访问模式处理得更顺,让5万多个核心有活干、少等待。第七代NVLink负责GPU之间的通信,把单卡层面的算力密度转化为集群层面的协同能力。Tom's Hardware根据核心数量推测,Rubin HPC可能采用了类似四芯片封装的布局——当前标准Rubin GPU是224个SM、28,672个CUDA核心,要跳到5万以上,单芯片很难装得下。英伟达没有公布HBM容量、带宽或FP64的具体配置,这让Rubin HPC在传统HPC最看重的双精度浮点性能上留下了一个待补的空白。
Vera机架:为“不加速”的那部分负载准备的
如果Rubin HPC负责的是加速计算,Vera机架解决的是另一类问题:那些没有被GPU加速、但仍然吃掉大量算力和内存带宽的科学负载。气候建模、分子动力学,以及智能体在规划、调度和数据准备阶段产生的CPU侧压力,都属于这一类。每颗Vera CPU的88个Olympus核心和176个线程,配合SOCAMM2 LPDDR5X内存提供的单颗1.2TB/s带宽,目标很明确:让数据密集型的CPU任务不再成为GPU等待的瓶颈。192颗CPU通过Quantum-X800 InfiniBand互联,整机架聚合峰值内存带宽超过200TB/s,全液冷MGX设计复用了NVL72的机架组件,部署和运维的复杂度被压了下来。
能效是Vera机架另一个被官方重点强调的维度。英伟达的测试显示,在OpenFOAM的motorBike大尺度气流仿真中,Vera的性能达到x86系统的1.9倍,每瓦性能为2.4倍;在开源天气预报模型上,性能提升1.6倍,能效提升2倍。德国气候计算中心DKRZ已经把Vera CPU选入其HLRE-5超级计算机,用于公里级气候模拟,系统预计2028年初上线。这个案例说明,Vera机架要争取的不是“跑分冠军”,而是那些对能效和内存带宽有硬约束的真实科学设施。
两条时间线,一个共同的赌注
Rubin HPC的2028年和Vera机架的2027年,在时间上错开了一年。这个节奏本身有信息量:Vera机架先落地,把CPU侧的内存带宽和能效底座铺好,让现有的HPC代码和智能体框架有一个可以运行的环境;Rubin HPC随后进场,把GPU侧的仿真吞吐推上去。英伟达超大规模与HPC副总裁Ian Buck的表述把两者的逻辑串在了一起:对于做科学和工程的智能体来说,更快的仿真意味着更快的发现。智能体可以不知疲倦地提出候选分子、候选材料、候选设计,但每一个候选都需要仿真来验证。仿真越快,智能体探索的空间就越大,科学家和工程师就能把实验资源投向最有希望的路径。
这套叙事的说服力取决于一个前提:智能体在科学工作流中的角色,真的会从“偶尔调用的工具”变成“持续运转的探索引擎”。如果这个前提成立,Rubin HPC和Vera机架的组合就是为那个未来准备的底座;如果智能体的科学应用停留在试点阶段,那么5万个CUDA核心和300TB内存的机架,也不过是又一代性能更强的硬件。英伟达在SC26上给出的不是答案,而是一份押注:它赌的是科学发现本身会变成一种智能体驱动的、持续运转的工作负载。2027年的Vera机架和2028年的Rubin HPC,是这份赌注的第一批筹码。
(素材来自:NVIDIA 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。