

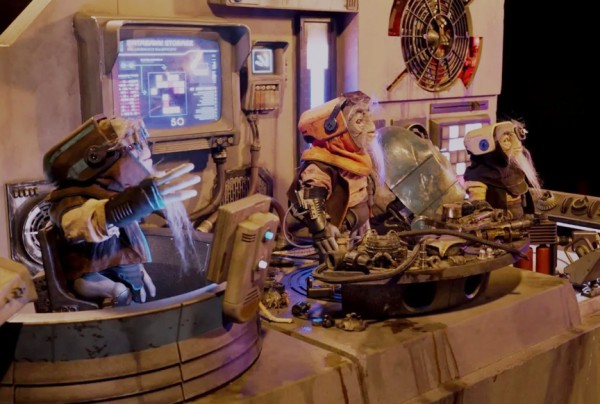
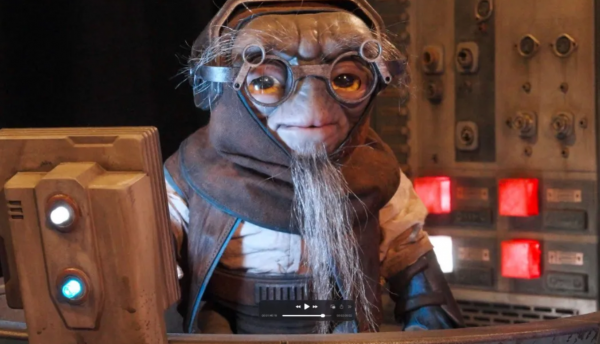
华特迪士尼幻想工程研发部门在11月18日公开了三款全新的音频动画原型机,名字分别是Vilo Vele、Kado Bre'a和Jibu Bre'a。它们不是常见的米奇或公主,而是《星球大战》宇宙里体型小巧的Anzellan种族——和《天行者崛起》中的Babu Frik同属一族,并在今年上映的《曼达洛人与古古》中扮演了更重要的角色。
三台机器人被放在一个板条箱里,各自拥有截然不同的性格,能够同时注意到走近的游客,用英语和Anzellan语混杂的方式开口说话,彼此之间还会互相接话。迪士尼幻想工程研发与技术高级副总裁凯尔·劳克林给出的定性相当直接:“这些Anzellan是我们目前在世界上最先进的音频动画。”
没有人在幕后握着遥控器
这句话的分量需要放在迪士尼六十年音频动画的历史里才能看清。从加州迪士尼乐园“魔法提基屋”里第一代会唱歌的机械鸟开始,迪士尼的音频动画角色绝大多数沿着两条路径运行:要么执行一套预先编排好的固定动作和台词,每一场演出完全相同;要么由隐藏在幕后的操作员实时操控,让角色看起来像是“活的”。此前亮相的奥拉夫机器人就是一个典型:外形讨喜,动作流畅,但幕后有人悄悄握着一台Steam Deck在驱动它。
Anzellan走的是第三条路。三台机器人各自配备了隐藏摄像头和麦克风,用来捕捉游客的动作和语音,数据被送往运行在AWS云服务器上的多个AI模型进行处理。架构上分为两层:一个“快速决策模型”负责生成即时反应,比如在游客靠近的瞬间迅速做出眼神接触,让人觉得“它注意到了我”;另一个规模更大的模型负责规划时间跨度更长的互动,决定接下来该说什么、该让哪个角色接话。没有任何人在后台拿着手柄替它们做决定。
AI只负责“选”,不负责“写”
这里有一个容易被忽略但至关重要的边界。Anzellan的动作和台词并非由AI实时生成。每一句对白、每一个头部倾斜的角度、每一次眨眼,都是由迪士尼幻想工程师提前写好并存入系统的。AI做的事情是在正确的时刻选择正确的台词和动作组合,然后触发执行。劳克林在接受采访时对此毫不含糊:AI协助引导行为,但Anzellan“从不偏离剧本”。
这套“人写剧本、AI选段”的架构,恰好绕开了生成式AI在主题乐园场景里最大的风险:不可控。一个实时生成对白的角色,在实验室里或许足够有趣,放到每天面对成千上万名游客的零售空间里,任何一次不合适的输出都可能演变成公关事件。迪士尼的选择是保留全部创作控制权,把AI的用武之地严格限定在感知和调度层面。AWS方面将这套逻辑概括为“物理AI”:每一个词、每一个手势、每一种性格特征都由幻想工程师手工打造,AWS提供的是让这些创作选择在真实世界中实时落地的决策能力。
“读空气”比对话更难
三台Anzellan真正展示的能力,与其说是对话,不如说是场景理解。劳克林描述了一个具体的画面:游客走进一家体验式零售店,迎接他的不再是预录的欢迎动画,而是三个各有脾气的小家伙根据房间里的人数、年龄构成和游客身上的细节做出不同的反应。戴着生日徽章的游客可能会收获一阵兴奋的叫声,穿着特定星战T恤的人可能被其中一个角色用挑剔的眼神打量一番。
三台机器人之间的协同是另一个技术难点。它们不仅回应游客,也回应彼此——一个说完,另一个接上,没有中央调度员在后台分配发言顺序。这种多智能体在物理空间里的实时协调,比单台机器人的对话生成更接近真实社交场景的复杂度。
(素材来自:华特迪士尼幻想工程、AWS 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。