

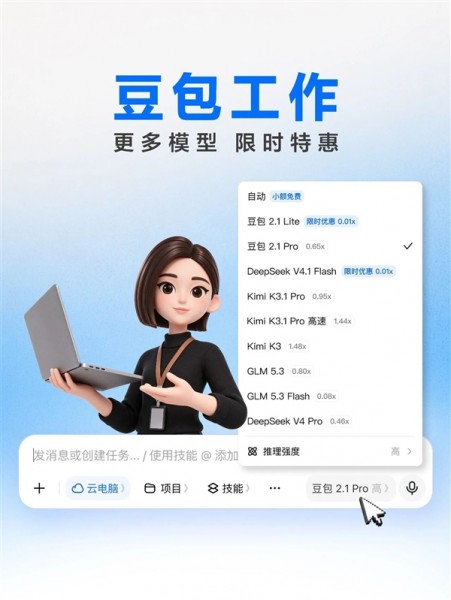
11月12日,豆包旗下AI智能体办公产品“豆包工作”完成了一次产品更新。此前,用户在豆包工作中能调用的模型只有两个:豆包2.1 Lite和豆包2.1 Pro,均为自研。更新之后,可选列表里新增了三个名字:Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash。用户可以在自研模型与第三方模型之间,按任务需要自行切换。
这个变化的直接含义是,豆包工作从一个“自研模型的办公入口”,变成了一个“多模型能力的调度台”。不同模型在写作、长文档编辑、代码、检索等任务上的表现各有长短,让用户根据实际工作需要去选择,本质上是把“模型选型”这个原本属于技术团队的决策,下放到了每一个使用办公AI的人手里。
企业先走了一步,个人用户现在跟上
这次更新并非一蹴而就。10月29日,豆包工作已经先向团队订阅版和企业订阅版客户开放了第三方模型配置。企业无需另行向模型厂商采购或额外申请,用量直接扣除已有的AI点数。11月12日的更新,把这一能力从企业客户扩展到了更广泛的用户范围,并配套上线了面向所有用户的限时优惠计划。
这条路径的次序值得留意。企业客户对成本核算和多模型适配的需求更明确,先在B端跑通“第三方模型按点数扣费”的流程,再把同一套机制推向个人用户,降低了产品更新的风险。对于一家办公产品而言,这意味着多模型能力不是一次性的功能发布,而是一套计费和调度基础设施的逐步铺开。
额度消耗倍率:把“哪个模型更划算”写在界面上
引入多模型之后,一个无法回避的问题是成本。不同模型完成同一任务时的资源开销并不相同,如果用户看不到这层差异,“自由选择”就可能变成盲选。豆包工作的解法是在模型选择页面直接标注每款模型的“额度消耗倍率”。倍率系数越低,完成同一任务消耗的额度越少。
这个设计的核心在于把权衡前置。用户不必再凭直觉猜测哪款模型“更划算”,选择依据被直接放在了操作界面上:要效果,选倍率高的;要速度或成本,选倍率低的;任务简单,系统会自动匹配免费的小额模型。额度消耗倍率不改变任务本身的复杂度,但它决定了用户账户里的额度能以多快的速度被消耗掉。把“计价系数”公开,等于承认了一个事实:在办公场景里,不存在一个“在所有任务上都最好”的模型,只有在特定任务、特定成本约束下“更合适”的模型。
限时优惠的方向:高频轻量任务被单独照顾
与多模型上线同步推出的限时优惠,可以拆成两个方向来看。其一是在工作日及节假日的指定优惠时段内,使用参与活动的模型可享受额度消耗折扣。其二是针对豆包2.1 Lite和DeepSeek V4.1 Flash两款模型直接下调额度消耗倍率。
这两款被单独下调倍率的模型,定位上都偏向高频、轻量的办公场景。把它们的倍率调低,效果会随着使用频次放大:一个每天要处理几十份短文档、邮件和会议纪要的用户,对单次任务成本的变化最为敏感。豆包工作同时保留了简单小额任务的免费权益,系统会自动匹配模型处理这类任务。这套组合的意图是清晰的:让高频轻量任务尽量便宜甚至免费,把付费额度的消耗集中在需要更强模型能力的复杂任务上。
办公AI的竞争,正在从模型转向“场景与控制”
业内人士对这次更新的一个判断是,豆包工作想把“模型能力”商品化。这个判断的落点不在“商品化”这个词本身,而在它背后的竞争逻辑位移。当办公AI产品只能调用自家模型时,竞争的核心是“谁的模型更强”;当产品可以同时调用多家模型、并把选择权和计价权交给用户时,竞争的核心就变成了“谁能把合适的模型嵌进文档、表格、会议、邮件这些具体场景,同时让成本可控”。
豆包工作目前提供的,是一套“模型货架+计价标签”的基础设施。货架上摆着自研的豆包2.1系列和首批第三方模型,标签上写着每一款模型的额度倍率,用户按任务自取。这套模式能否成立,取决于两个尚未被回答的问题:用户是否愿意花时间去理解“倍率”的含义并做出选择,以及第三方模型的调用体验能否在豆包工作的智能体框架内保持稳定。但至少,它把“办公AI该用什么模型”这个问题,从产品团队的默认设置,变成了用户手里的一个可操作选项。
(素材来自:豆包 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。