

推理功耗的结构性矛盾:大部分电花在了“搬运”而不是“计算”上
AI推理的功耗结构,与训练有本质区别。训练是持续的、均匀的高负载,功耗曲线相对平稳;推理则是阶段性的,Prefill阶段一次性消化整个提示词和上下文,计算密集但持续时间短;Decode阶段逐token生成,单步计算量小,却需要反复从显存中读取参数和KV缓存,时间占比高、总能耗大。
数据中心目前消耗全球约1.5%的电力,而推理正在成为其中增长最快的部分。传统GPU架构的问题不在于算不动矩阵乘法,而在于为通用性付出的代价:电信号在铜互连上的损耗、为散热预留的功耗余量,以及网络瓶颈导致的GPU空转。
光学AI切入的,正是这条功耗曲线中最不经济的几段。
光计算:在Prefill阶段用光“算”,把能效推到另一个量级
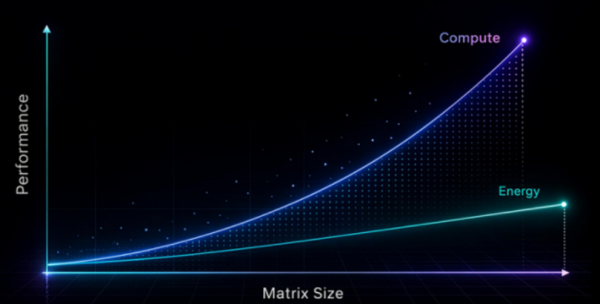
光计算的核心主张很直接:矩阵乘法是AI推理中最主要的计算模式,而光在自由空间或波导中的传播、干涉和叠加,天然适合执行线性变换。用电信号做乘法需要晶体管开关,用光信号做乘法只需要调制光的强度或相位,计算本身消耗的能量接近于零。
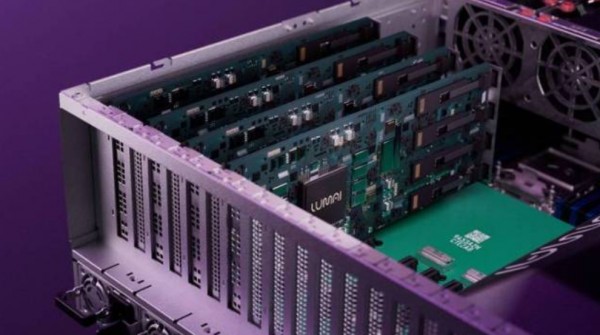
Lumai的Iris Nova是这一路径近期最具体的落地样本。2026年11月,Lumai在英国ARIA Scaling Inference Lab部署了这台光学推理服务器,目标是从GPU手中接管Prefill阶段的工作负载。它的架构是混合式的:光学引擎负责矩阵乘法,电子部分负责内存、控制和非线性函数。Lumai宣称,在同等性能下,Iris Nova的能耗可降低高达90%,核心逻辑是“计算本身不耗电,功耗只随光电转换和激光源线性增长”。它的设计功耗预算被控制在10kW级别,目标能效是100 TOPS/W。
Lightmatter则从芯片封装层面推进了另一条路线。其六芯片3D封装的光子处理器,集成了约500亿个晶体管和100万个光子元件,在65.5万亿次16位ABFP运算/秒的吞吐下,电功耗为78W,光功耗为1.6W。更关键的是,它能够不加修改地运行ResNet、BERT等现有模型,而不需要专门的量化或重训练。这意味着光计算不必等待软件生态的重写,就能进入现有的推理管线。
这两条路线的共同点是:它们都不试图替换Decode阶段。Lumai的产品负责人明确表示,Decode阶段受限于显存带宽,不适合光计算;训练也不适合,因为精度和权重更新的要求超出了当前光计算的舒适区。光学AI在计算侧的定位是“接管Prefill”,而不是“取代GPU”。
光互连:不改变计算,改变GPU“等待”的时间
如果光计算解决的是“算”的功耗,光互连解决的是“等”的功耗。在当前的AI集群中,电子交换机是网络核心的功耗大户,也是延迟和GPU空闲时间的来源。Oriole Networks的PRISM平台用纳秒级光路交换取代了核心网络中的电子分组交换机,宣称将核心网络功耗降低81%,并将GPU空闲时间从约60%压缩到1%以下。
这个数字需要放在语境中理解。60%的GPU空闲时间意味着,在推理负载下,超过一半的GPU算力因为数据搬运和网络调度而处于闲置状态。削减这部分空闲时间,等价于在不增加GPU数量的前提下,提升有效算力的产出。Oriole的系统与AMD Instinct GPU和EPYC CPU配对部署在英国ARIA实验室中,其81%的功耗降幅和亚1%的空闲时间目前仍是厂商声明,尚未经过独立基准测试的验证。
Lightmatter在互连一侧的数据提供了另一个参照。其光子互连方案在1152 GPU的Pod架构中,可将Prefill阶段的延迟降低最高5.7倍,对于13万token的长上下文工作负载,首token延迟可降低3倍。延迟的降低本身不直接等同于功耗的降低,但更快的完成时间意味着更短的活跃功耗窗口。
光电转换:节能叙事背后那道绕不开的物理成本
光学AI的节能承诺有一个共同的物理前提:光本身不携带电荷,计算过程中的能量耗散极低。但这个前提只在“光已经在光域中”时成立。现实中的推理系统是电学的,数据以电信号存储在HBM中,以电信号在网络中传输,以电信号被控制和调度。每一次在电域和光域之间跨越,都需要激光器、调制器、光电探测器来完成信号的转换,而这些转换消耗的能量,构成了光学AI的“隐性账单”。
Lumai的10kW功耗预算和100 TOPS/W的目标能效,衡量的正是包含光电转换在内的整机效率,而不仅仅是光学矩阵乘法本身的能耗。Lightmatter的78W电功耗与1.6W光功耗的并列,也说明光学计算的“零能耗”是一个关于计算介质的描述,而不是关于整台服务器的描述。学术侧的进展给出了更极端的乐观数字,例如约20aJ/MAC的光学矩阵乘法能耗,但这些数字通常是在受控实验条件下、针对特定矩阵尺寸和精度要求测得的,距离一个需要在真实数据中心中持续运行、散热和维护的商业系统之间,仍有相当的距离。
当前的位置:接管一段,而非替换全部
光学AI在推理功耗上的真实进展,可以用一条分界线来概括:在Prefill这种计算密集、精度要求相对可控的阶段,光计算已经拿出了可部署的硬件和可量化的能效数字;在Decode这种显存带宽受限的阶段,光学方案尚未证明其优势;在网络互连层面,光子交换对功耗和GPU利用率的改善是方向明确的,但81%和亚1%这类数字仍处于厂商声明的阶段,独立验证尚未完成。
这并不意味着光学AI的影响力有限。Prefill在长上下文推理中的功耗占比正在快速上升,而网络瓶颈导致的GPU空转是当前AI集群能效中最容易被忽视的一块。光学技术在这两个位置上的介入,削减的不是“计算的功耗”,而是“不计算时的功耗”和“为了搬运而付出的功耗”。前者由Lumai和Lightmatter在Prefill阶段推进,后者由Oriole在互连层推进。它们加在一起,构成了推理功耗结构中最不经济的那一部分的解法。至于这套解法能否从实验室和厂商测试台走向大规模数据中心的日常运行,答案不在能效数字里,而在接下来几个季度中,那些部署在ARIA实验室和早期客户环境里的光学服务器,能否在真实负载下跑出与宣传一致的功耗曲线。
(素材来自:Lumai、Lightmatter、Oriole Networks 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。