

一年四款系统,底层只有两颗芯片
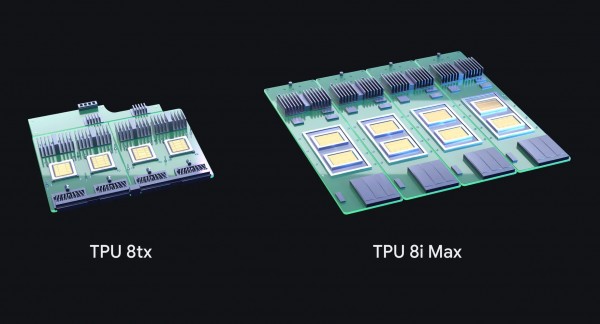
2026年11月9日,谷歌云宣布扩充第八代TPU产品线,新增TPU 8i Max与TPU 8tx两款系统。加上今年4月发布的训练芯片TPU 8t和推理芯片TPU 8i,谷歌首次在一年内交付了四套TPU系统。谷歌云AI与计算基础设施副总裁兼总经理Mark Lohmeyer在媒体简报中给出的背景是:TPU业务目前拥有近100家客户,涵盖前沿实验室、交易公司、零售商和大学,需求正在从单一的模型训练向智能体推理和机密计算扩散。
但需要先厘清一个关键事实:四款“系统”不等于四款“新芯片”。第八代TPU的底层硅片只有两颗——面向大规模训练的8t和面向实时推理的8i。11月9日亮相的两款新品,全部由这两颗已有芯片通过封装重组、主机CPU替换和互连网络切换衍生而来。谷歌高级副总裁Amin Vahdat在博客中将这一策略概括为“围绕芯片构建系统”:当AI软件的迭代速度远快于硅片制造周期时,通过调整封装、高速内存、光网络和安全模块来快速交付专用超级计算机,比等待新一代流片更符合行业的节奏。
TPU 8i Max:把两颗推理芯片塞进一个封装,用密度回应内存墙
TPU 8i Max的工程逻辑可以用一句话概括:当智能体需要在百万级上下文中持续推理时,瓶颈已经从算力转移到了内存带宽。处理长文档、长视频或整个代码库,意味着芯片需要在内存和计算单元之间反复搬运海量数据;如果带宽不够,算力再高也会被数据搬运卡住。
谷歌的解法是物理层面的密度堆叠。TPU 8i Max将两颗TPU 8i芯片合封在同一个多芯片封装内,算力、片上SRAM和HBM带宽全部翻倍。具体规格上,片上SRAM从384MB翻倍至768MB,HBM总容量达到384GB(部分来源表述为576GB HBM,对应双芯片合计),HBM带宽冲上17.2TB/s,单颗基础版8i的8.601TB/s被直接翻倍。更关键的是,这一切被塞进了与单颗8i相同的机架占地面积内,单位面积和单位功耗下的计算密度随之翻番。
谷歌设计8i Max的参照系是其Gemini前沿模型所支持的100万token上下文窗口——大约相当于75万英文单词或1500页文本。当智能体需要跨越多份文档、数小时视频或多模块代码库进行推理时,内存带宽就是决定响应速度和单任务成本的底层变量。8i Max不是为通用计算设计的,它是为“让智能体记住并处理更多东西”这一特定需求定制的加速器。
TPU 8tx:在硬件层挖一个“加密飞地”,让敏感数据在计算中也不解密
TPU 8tx解决的是另一个维度的问题:合规。对于银行、政府机构和受监管行业而言,数据在存储和传输时加密是常规操作,但当AI模型真正处理这些数据时,它们必须在内存中被解密。这个“解密窗口”是安全链条上最薄弱的环节。
8tx的做法是将安全边界下沉到硬件层。它在与TPU 8t相同的硅片基础上,搭配了定制的第五代AMD EPYC Turin主机CPU,在芯片层面构建了一个隔离的可信执行环境(TEE)——也就是“机密计算”所依赖的加密飞地。敏感数据和模型权重在整个推理过程中保持加密和隔离,无需在计算前解密,也无需在不同集群之间迁移数据。Lohmeyer给出的性能代价是“接近零”,延迟比基础版TPU 8t低至一半(最高2倍改善)。
网络一侧,8tx没有沿用8t面向训练的3D Torus拓扑,而是切换到了8i的Boardfly互连网络,最大网络跳数从16跳压缩到7跳,这对多步骤智能体需要连续发起大量顺序推理调用的场景更为友好。一个银行或政府机构可以在同一套机密系统上完成模型的微调、蒸馏和强化学习训练,而不必把敏感数据在多个集群之间搬运。对于此前因为合规限制而无法将AI工作负载放入公有云的客户而言,8tx提供的是一条“数据不出安全边界,但模型可以持续迭代”的路径。
硬件贴到了B300的胸口,但价格和生态仍是盲区
如果将参数拉平对比,谷歌第八代TPU在硬件规格上确实已经贴近了英伟达的主力产品。雅虎财经的测算显示,英伟达下一代Rubin芯片算力可达35 PFLOPS,而TPU 8i约为10 PFLOPS、TPU 8i Max约为20 PFLOPS。博通CEO在9月的表态更为直接:全新谷歌TPU性能与英伟达Vera Rubin“持平或更优”。在内存带宽这一8i Max专门瞄准的维度上,17.2TB/s的账面数字已经构成了足够的竞争压力。
但硬件采购看的从来不是孤立的峰值数字,而是除以价格和折损后的真实产出。TPU v8全系至今没有公布云端按需单价,这意味着采购方无法计算真实的单token成本,也无法将TPU的性价比与英伟达GPU方案放在同一张财务模型里比较。两周前开源的原生PyTorch后端TorchTPU降低了迁移门槛,但其底层目前仅支持约450个算子,动态shape重编译等限制意味着现有的CUDA代码无法“零成本搬家”。谷歌在博客中强调的“模块化定制硅片+开放易用的软件栈”是正确方向,但从方向到生态成熟之间,隔着算子覆盖、性能调优和开发者习惯的漫长积累。
系统级速度,与生态级耐力
谷歌第八代TPU的扩列方式,揭示了一种与英伟达不同的竞争逻辑。英伟达依赖架构代际的跃迁来定义节奏,而谷歌选择在单一代际的硅片基础上,通过封装、网络和主机CPU的组合变化来快速响应细分需求。一年四款系统的交付速度,证明这种“系统级”策略在工程上是可行的,它让谷歌能够在几个月内针对智能体推理和机密计算两个明确的刚需,拿出有竞争力的配置,而不必等待下一轮流片。
但速度解决的是“有没有对的产品”,生态解决的是“客户愿不愿意持续用”。8i Max的内存密度和8tx的加密飞地,在各自的问题域里都是扎实的答案。它们能否转化为实际的采购决策,取决于两个尚未公开的变量:TPU的定价策略,以及TorchTPU能否在算子覆盖和易用性上追平CUDA的开发者体验。硬件已经摆上了桌,价签和工具链是下一道必须过的关。
(素材来自:Google Cloud 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。