

单纯增加显存已经走不通
随着大模型参数越来越庞大,上下文窗口持续拉长,加上AI智能体Agent的落地普及,当下AI推理集群正遭遇越来越严峻的内存考验。很多人的第一反应是继续增加GPU的HBM高带宽内存,依靠更大显存承载更多数据。
英伟达近期发布技术博客提出不一样的看法,一味堆高单卡HBM容量,并不能持续带来推理吞吐量的同步增长。HBM本身不仅采购成本高昂,供应链供给也存在限制,把所有数据全部塞进GPU显存并不是经济可行的路线。
用通俗的比喻来讲,HBM就相当于仓库,内存带宽是仓库的装卸码头。就算仓库面积不断扩大,如果货物进出的码头处理能力跟不上,新增的存储空间就会闲置,只会徒增成本和功耗,实际业务处理能力不会随之提升。
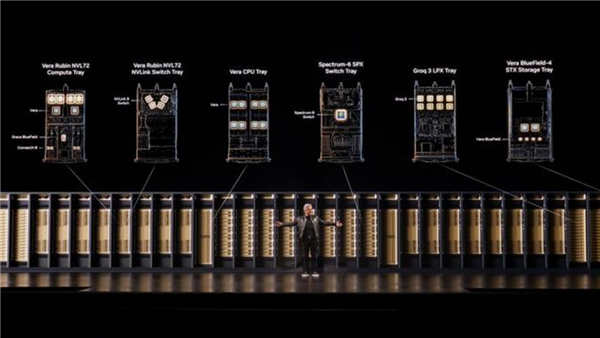
当GPU的算力、带宽成为新瓶颈之后,再多的显存也没办法服务更多并发用户,会出现显存资源闲置浪费的现象。想要改善现状,需要把GPU、CPU、网络、存储、配套软件放在一起统筹设计,打造分层的内存存储体系,让不同的数据流动到最合适的硬件层级当中。
AI推理场景内存压力来自哪里
推理环节里,两大块内容会持续消耗宝贵的HBM资源,分别是模型权重和KV Cache缓存。除此之外RAG检索增强生成业务带来的向量检索数据,同样会抢占显存空间。
KV Cache用来保存已经运算完成的上下文信息,避免模型反复重复计算相同内容,以此加快生成速度。而Agent智能体任务特点是多轮交互,会反复调用外部工具,任务会话会不断累积历史对话内容。部分实际业务当中,单次任务处理上下文规模最高能够达到300万token。
RAG业务会把企业内部文档转换成向量数据做检索匹配,如果全部向量索引都常驻在GPU显存中,会进一步挤压推理任务可用资源。种种因素叠加,进一步放大了对HBM的需求。
多维度优化降低HBM资源消耗
针对模型权重占用显存过高的问题,英伟达采用NVFP4四比特低精度格式做权重压缩,不少企业已经开始发布基于NVFP4格式的模型文件。同时借助NVLink互联技术搭建NVL72机架级系统,整套机架最多可把一份大模型拆分存放在72颗GPU上面。
单颗GPU只需要保存模型的部分参数,省下大量HBM空间留给KVCache,以此支撑更多并发访问。这套方案依靠量化压缩加上机架分布式存储,减少单卡存储压力,而不是依赖不断拉高单卡显存规格。
KV Cache的优化则分为压缩、加速调度、分层卸载三个方向。NVFP4同样可以对缓存内容压缩,减少内存占用。Vera CPU可以加速Agent的工具调用流程,缩短缓存闲置等待的时间。这款CPU自带大容量LPDDR内存,经由NVLink‑C2C和GPU直连,可以临时存放暂时不活跃的上下文数据。
Dynamo推理软件还可以把长时间不活跃的KV Cache,迁移到CMX上下文存储平台。CMX的每比特存储成本远低于HBM,还支持跨服务器共享,省去传统存储长期备份带来的额外开销。等到会话需要再次读取,再快速把数据调回GPU。软件层面还能够在整个集群范围内复用已经生成完成的KV Cache,减少重复运算。
针对RAG向量检索业务,NeMo Retriever工具可以生成体积更小、检索精度不降的向量,cuVS库支持把大型向量索引部署在CPU内存以及存储设备。只有检索命中需要实际参与推理的片段,才送入模型上下文,向量索引本体不用占用GPU显存。
实际基准测试带来显著效率提升
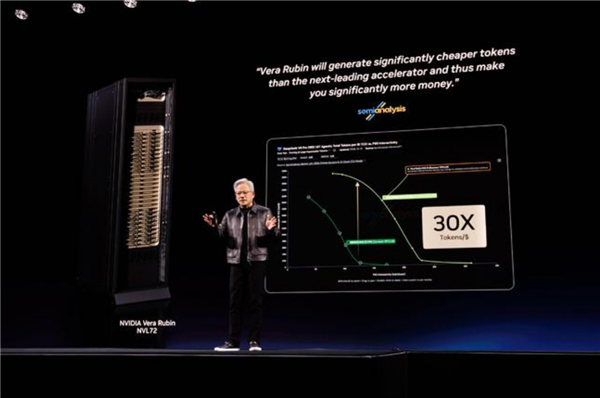
相关性能结果来自SemiAnalysis AgentX基准,测试选用DeepSeek V4Pro智能体工作负载。在每用户每秒100token的条件下,GB300 NVL72对比H200平台,每美元投入可以获得的吞吐量最高提升十倍,此时单卡HBM容量接近翻倍。
切换到每用户每秒125token的测试条件,Vera Rubin NVL72对比GB300 NVL72,单位成本对应的吞吐量最高实现三十倍提升,而单颗GPU的HBM容量仅仅提升大约3%。
这份测试结果充分证明,系统级全栈协同优化带来的收益,可以远远超过单纯升级硬件显存规格。把活跃数据留在高速HBM,闲置数据下移到低成本存储介质,配合量化、分布式、缓存卸载一系列手段,现有硬件资源可以承载规模更大的AI业务。
未来AI算力评估的重点,不再只看芯片的峰值算力、显存总大小,还要衡量整套基础设施如何调度不同层级存储,每一分成本能够产出多少有效的token。
(素材来自:英伟达 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。