

英伟达发布开源语音转录大模型,多人重叠对话识别成为亮点
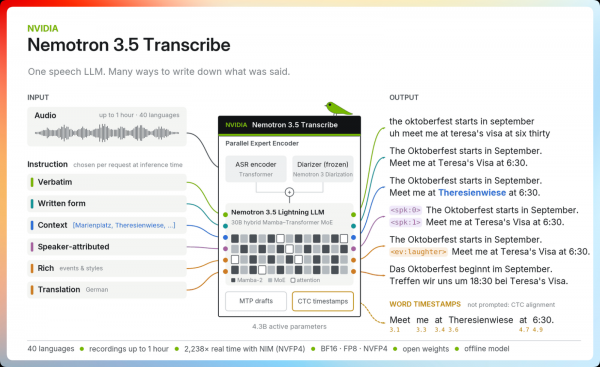
10月28日,英伟达对外推出Nemotron3.5 Transcribe开放权重语音模型,与之配套的训练数据处理管线Granary v2也一并对外公开。这套工具集合,把语音转写、说话人区分、音频翻译以及音频问答能力整合在一起,面向不少现实业务场景提供技术底座。
企业会议纪要整理、课堂录像转写、深度访谈文稿生成、跨语言客服对话处理,都是这套模型的目标落地场景。以往很多语音识别产品遇到多人同时发言、互相抢话的录音,很容易出现角色混淆、文本错乱,而这款模型把解决重叠人声识别作为重点打磨方向。
MoE 架构加持,多语言与长音频处理能力突出
Nemotron3.5 Transcribe选用混合专家也就是MoE架构,整体总参数量大约340亿,推理阶段实际激活参数量为43亿。单次可以处理最长一小时的完整录音素材,能够完成四十种语言的转录工作,其中三十一种语言还可以实现和英语的双向互译。
在说话人区分能力上,模型最多可以分辨八位不同的发言者,十三种语言环境下都支持说话人标记输出。比较有特点的设计在于,它在生成文字稿件的过程当中,就同步完成每一段语句的发言人归属标注,不需要后期二次拆分匹配。
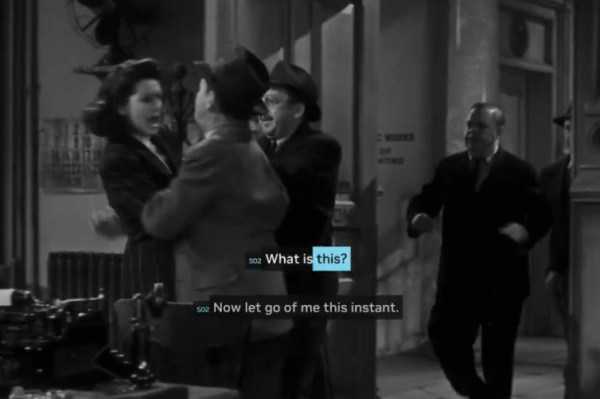
英伟达放出的演示案例选取老电影《他的女友礼拜五》片段,片段内部语速飞快,大量对白互相交叠,模型依旧可以完成分角色字幕输出,直观展示应对嘈杂重叠人声的实际效果。
多项公开评测交出亮眼成绩,多平台免费对外开放
在第三方公开评测榜单当中,该模型拿到了不错的排位。在Hugging Face Open ASR Leaderboard英语组别,它以5.33%的平均词错误率位列开源模型第一位。在 Artificial Analysis 非流式词错误率指数评测里,取得2.8%的成绩,和Voxtral Small Transcribe并列开源模型榜首。针对说话人分离任务,David AI的二十一种语言基准测试下,它拿到18.26%的最低错误率。
普通开发者可以直接在Hugging Face以及ModelScope平台获取模型文件,项目遵循OpenMDW‑1.1许可证。官方表示后续还会推出量化版本,方便部署在RTX Spark、DGX Spark、Jetson AGX Thor这类本地硬件设备上运行,降低端侧部署的硬件门槛。
Granary v2配套数据管线,产出多种风格转录文稿
同步对外公开的Granary v2,是英伟达专门为多语言语音模型打造的可复用训练数据集与处理管线。这套工具可以把原始音频、已经标注好的音频素材,自动转换成转录文稿、翻译文本、字幕、问答指令对等多种格式,服务自动语音识别、语音翻译相关模型微调工作。
整套数据源覆盖463062小时音频内容,包含48种语言,整合16个不同原始语料库,对比上一代Granary v1的25种语言实现明显扩充。
针对同一套音频素材,管线能够输出至少三类不同风格转录结果。一类是文本规范化逐字稿,保留口语里面“嗯”“呃”这类语气词,同时规范数字书写格式。第二类保留口语卡顿语气,但是把数字改写为书面符号。第三类会剔除犹豫语气词,输出干净整洁适合直接对外发布的成品文稿。三种不同输出形式,可以满足笔录存档、对外文稿、资料整理等不一样的业务诉求。
语音大模型的竞争,不只有模型本身能力,高质量训练数据同样是重要壁垒。英伟达同时开放模型与数据处理管线,也给行业内语音技术研发提供了可以复用的参考工具。
本文由智算芯能前沿网编辑整理,转载请注明出处。