

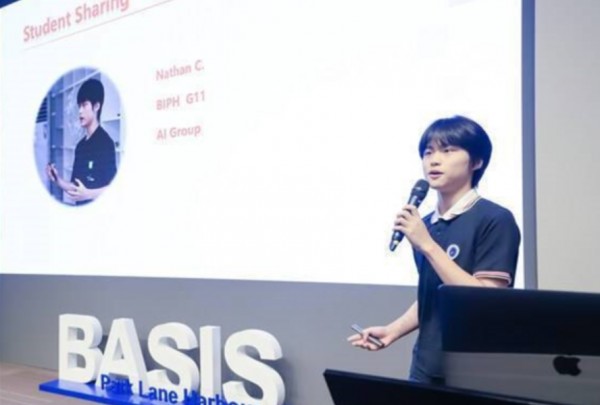
10月15日,17岁的陈广宇在社交平台发文,宣布离开月之暗面Kimi团队。他在帖文中感谢了公司在他16岁时给予的信任和工作机会,并表示希望继续探索新方向,但没有透露下一步的去处。
这条帖子很快在AI社区引发了超出其篇幅的关注。几乎在同一时间,Anthropic可扩展强化学习方向研究员肖尔托·道格拉斯出现在评论区。道格拉斯是前DeepMind Gemini推理架构负责人,他在评论中询问陈广宇是否仍计划前往卡内基梅隆大学深造,并邀请他前往旧金山,与Anthropic内部的Prime、Base10等团队一起工作。陈广宇的回复是:“谢谢肖尔托!我正要去湾区。”
但“去湾区”不等于“加入Anthropic”。10月20日,长期追踪硅谷AI人事变动的匿名账号Arfur Grok爆料称,陈广宇已经加入美国AI初创公司Discovery Loop。这家公司由谷歌前首席科学家杰夫·迪恩(Jeff Dean)与其他三名谷歌老将共同创办,2026年8月成立,致力于开发直接参与科学和工程研究的AI产品。
截至10月28日,陈广宇本人和Discovery Loop均未对这一传闻做出公开确认。
一个17岁高中生的研究,为什么能进入Kimi K3的底层
陈广宇在Kimi的工作时间不超过一年。2025年11月,他以16岁的年龄加入月之暗面,担任机器学习研究员。他此前曾入选罗德信托“高潜力未来领袖计划”,并在美国小型AI研究实验室Tilde Research做过研究。
真正让他进入AI圈视野的,是2026年3月Kimi发布的技术报告《Attention Residuals》。这篇论文对深度学习沿用近十年的残差连接结构进行了重新设计,陈广宇与苏剑林、张宇一同作为共同第一作者。残差连接是大模型每一层之间信息传递的基础机制,十年来的主流做法是将此前各层的信息逐层累积传递。Attention Residuals改为对前序不同层的信息进行选择和聚合,而不是无条件累加。
这项研究的关键工程难题在于开销。完整版的Attention Residuals带来的额外计算和通信成本,在大规模训练中难以承受。把它从“完整版开销无法承担”变成可行方案的,是张宇与陈广宇共同提出的Block AttnRes(分块注意力残差),将额外开销控制在5%以内,换来约20%的训练效率提升。实验显示,在Kimi Linear 48B模型上,等效于多用约25%算力,推理延迟增加不到2%。
这项技术随后落地为Kimi K3的底层支撑之一。Kimi K3总参数达到2.8万亿,是全球首个达到这一参数规模的开源模型。马斯克曾公开对这项研究表示肯定。一个17岁的高中生,在不到一年的时间里,参与了一项触及大模型底层结构的改进,并让它进入了一个2.8万亿参数模型的架构——这构成了后续一切关注的起点。
百万美元邀约:一个被广泛传播但未经证实的数字
围绕陈广宇离职最引人注目的传闻,是他收到了5份金额均在100万美元以上的工作邀约。这一说法最早来自风险投资人Deedy Das。他在社交媒体上提到,自己认识一位17岁的年轻人,收到了旧金山最顶尖初创公司的五份百万美元级邀约,但没有点名。此后,多家媒体在报道陈广宇时引用了这一传闻,但均未获得陈广宇本人或相关公司的确认。
把这一传闻放回语境中,需要区分两个层面。第一,硅谷对顶尖AI研究人才的争夺确实在加剧,百万美元级的薪酬包在资深研究员中并不罕见。第二,一个17岁、尚无大学学位的研究者是否确实收到了5份这一量级的邀约,目前没有任何一方公开证实。
关注度的真正落点,不在去向而在能力
陈广宇的去向之所以成为一个被反复讨论的话题,本质原因不在于“17岁”这个年龄标签本身,而在于他已经在生产级模型中留下了可验证的技术贡献。Attention Residuals和Block AttnRes是公开的论文成果,Kimi K3是已经开源的模型,两者之间的技术关联可以被独立审视。这使得围绕他的讨论有一个坚实的事实基础,而不只是对“天才少年”的叙事消费。
至于他最终加入哪家机构——Anthropic、Discovery Loop,还是先完成大学学业——目前都没有定论。道格拉斯的公开邀请和Arfur Grok的爆料指向不同的方向,而陈广宇本人的公开表态只到“正要去湾区”为止。对于一个17岁的研究者而言,第一份正式工作的选择本身并不需要被赋予过多的象征意义。真正值得留意的,是他参与开创的Block AttnRes方法,是否会在Kimi K3之外的模型上被进一步验证和采用。那才是衡量这项工作长期影响的标尺。
(智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。