

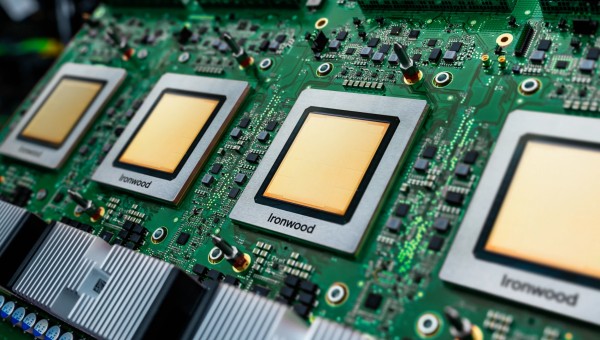
10月27日,甲骨文与谷歌宣布,谷歌TPU将接入甲骨文云基础设施(OCI),甲骨文由此成为谷歌以外首家提供TPU的超大规模云服务商。服务预计2027年推出,并在随后数年内逐步扩大规模,支持大模型训练、推理及AI智能体应用。谷歌第八代TPU包括面向训练的TPU 8t和面向推理的TPU 8i。
同一天前后,The Information报道,OpenAI计划采购谷歌TPU,相关财务条款和采购规模尚未披露。报道同时指出,OpenAI正在招聘一名工程师,负责“主导优化”公司最先进的前沿模型,使其能够在TPU上运行。招聘信息表明,这项工作仍处于早期阶段。OpenAI发言人此前曾表示,公司“目前没有专门使用TPU的计划”。
两件事指向同一个方向:谷歌的TPU正在从“谷歌云内部的专用芯片”,变成“可供外部客户在多个云平台上选择的AI算力”。而OpenAI的采购意向,是这个转变中分量最重的一个潜在客户信号。
英伟达的紧急电话,和那笔1000亿美元
要理解OpenAI采购TPU的传闻为什么敏感,需要回到2026年夏天。据《华尔街日报》报道,英伟达与OpenAI之间一笔高达1000亿美元的投资合作,在初步谈判中一度陷入僵局。转折点出现在OpenAI与谷歌云签署首份大规模合约、并传出可能采用谷歌TPU的消息之后。黄仁勋随即打电话给Sam Altman,询问传闻是否属实,并表示愿意让谈判重回正轨。一位与黄仁勋交谈的人士透露,他意识到英伟达可以通过直接投资OpenAI来帮助该公司获得所需的算力。
这笔投资最终以英伟达向OpenAI投资1000亿美元、OpenAI获得数百万颗AI芯片的形式落地。从供应商管理的角度看,这笔交易实现了一个关键目标:让OpenAI的算力路线继续以英伟达GPU为中心。有分析将这种安排称为“供应商锁定”——OpenAI在未来数年内将深度依赖英伟达的硬件,包括Vera Rubin系统。
但“锁定”这个词需要附带一个限定。锁定的是采购路径和基础设施投资,不是技术上的排他性。OpenAI仍然可以招聘TPU优化工程师,仍然可以在谷歌云或OCI上运行部分工作负载。1000亿美元买到的是一段优先合作关系,而不是一堵密不透风的墙。
甲骨文与谷歌的联盟:TPU的供给边界被推开了
如果说OpenAI的采购意向是需求端的信号,那么甲骨文与谷歌的合作则是供给端的实质性变化。在此之前,TPU只能通过谷歌云获取;OCI接入之后,客户可以在两家超大规模云服务商之间选择TPU算力,而不必把全部AI基础设施绑定在谷歌云上。
谷歌云博客对这次合作的描述透露了几个技术细节。TPU从芯片到软件是协同设计的,片上互连(ICI)配合光路交换(OCS),可以在硬件或链路退化时动态绕开故障路径,无需重启任务,在数千颗芯片的大规模训练中维持超过97%的goodput。第八代TPU单芯片原生FP4算力最高12.6 PFLOPS,能效比上一代提升最高2倍。推理侧,更大的片上SRAM、更多HBM容量和新的低直径互连拓扑将网络跳数减少50%以上,使低延迟服务的每美元性能提升最高80%。
另一个容易被忽略但影响深远的动作是软件生态。TorchTPU,谷歌面向TPU的原生PyTorch栈,已经在GitHub上开源。开发者可以在TPU上训练、服务和部署模型,使用vLLM、SGLang、Hugging Face、Ray等已有工具,而不需要重写模型代码。谷歌云博客的表述是,这种可移植性让团队可以为每个工作负载分配“每token成本最低或训练时间最短”的加速器。
这一点的战略含义比硬件规格更值得留意。过去TPU的主要障碍之一,不是绝对性能不够,而是迁移成本太高——模型和工具链需要为TPU做专门适配。TorchTPU的开源降低了这道门槛。当客户可以“不重写代码”地在GPU和TPU之间分配工作负载时,TPU的竞争定位就从“谷歌内部的替代方案”变成了“采购清单上一个可评估的选项”。
TPU 8t与8i:两条产品线,两种竞争逻辑
谷歌第八代TPU的拆分方式,也反映了AI算力需求本身的分化。TPU 8t面向训练,单超级集群可扩展至9600枚芯片,配备2 PB共享高带宽内存,提供121 ExaFlops算力,互连带宽是上一代的两倍。TPU 8i面向推理和AI智能体,配备288 GB HBM和384 MB片上SRAM,互连带宽翻倍至19.2 Tb/s,性价比提升80%。
训练芯片的竞争逻辑是“能不能把最大规模的模型跑起来”,推理芯片的竞争逻辑是“每token的成本和延迟能不能压到足够低”。后者恰恰是OpenAI这类公司随着模型部署规模扩大而越来越敏感的部分。如果OpenAI采购TPU的动机包含降低推理成本,那么TPU 8i的定位与这一需求是吻合的。报道中提到的“优化前沿模型在TPU上运行”,也可能指向训练侧的TPU 8t,而非单纯的推理卸载。
英伟达的回应:投资、产品与尚未闭合的窗口
英伟达对这一系列信号的反应并不只是那通电话。2026年10月,英伟达宣布投资200亿美元收购Groq的AI技术,这被解读为对TPU路线挑战的应对。黄仁勋同时公开确认,英伟达与OpenAI的合作与投资计划按预期推进,并将参与OpenAI新一轮融资,同时评估参与其IPO的可能性。另有消息称,英伟达计划在OpenAI新一轮融资中投入200亿美元。
这些动作的组合说明,英伟达并没有把TPU的威胁当作一个已经过去的插曲。投资OpenAI是为了维持关系,收购Groq技术是为了补齐推理侧的竞争力,两者指向同一个判断:AI芯片市场的竞争正在从“英伟达与其他所有人”变成“英伟达与一套逐渐成形的替代生态”。TPU是这套生态中最成熟的一支,甲骨文的接入扩大了它的覆盖面,TorchTPU降低了它的迁移门槛,OpenAI的采购意向则提供了一个高可见度的需求信号。
但这套替代生态距离真正撼动英伟达的位置还有距离。TPU在OCI上的部署要到2027年才开始,OpenAI的TPU优化工作仍处于早期,英伟达的GPU和CUDA生态在训练侧的深度和广度仍然是TPU短期内难以全面替代的。
(素材来自:甲骨文/谷歌/OpenAI/英伟达 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。