

40系显卡算力解锁热潮迎来终点
此前硬件圈子当中,RTX40系列消费显卡可以通过工具释放隐藏AI算力的话题引发大量讨论。不少AI爱好者借助技术手段,把游戏显卡被压制的张量核心性能完整释放出来,实现近乎翻倍的AI计算能力。不过随着Blackwell架构的RTX50系列到来,这套操作已经没有复制的机会。
根据相关硬件媒体报道,英伟达在RTX50消费级显卡上完成底层安全架构的重新设计,用硬件级别的防护手段,把此前被开发者利用的安全漏洞彻底封死。想要依靠软件、微码修改实现算力解锁,在这一代产品上已经没有实现空间。
消费显卡长久存在的算力限制逻辑
英伟达过往的产品策略里,不少消费级显卡和专业计算显卡会采用同源GPU芯片。芯片硬件本身具备完整的计算潜力,但厂商会通过硬件熔丝做限制处理。
在FP32累加这类AI高频运算场景,消费显卡的张量核心会被强制限制在半速运行,以此拉开游戏显卡和高价专业工作站显卡之间的性能差距。
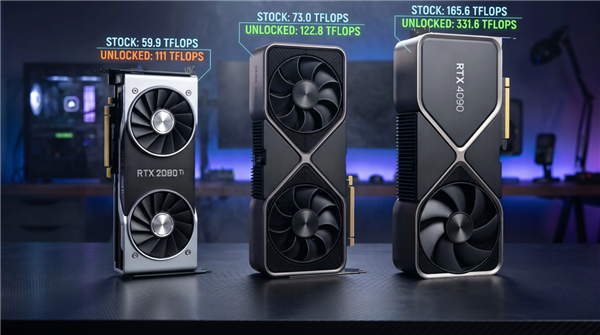
开源社区的开发者找到了SEC2安全控制器存在的缓冲区溢出缺陷,基于该漏洞开发出GPUUnlock相关项目。不需要改动显卡芯片硬件,就能够绕开官方施加的性能枷锁。以RTX4090为例,AI算力由原本的165TFLOPS提升到331TFLOPS,在大模型推理等AI任务上得到非常可观的性能跃升。
RTX50从底层重构安全防护体系
Blackwell架构的RTX50系列不再沿用旧的安全控制方案,整套固件启动流程进行大刀阔斧改动。产品搭载一套基于RISC-V指令集的FSP安全处理器,将它作为整套硬件的信任根基。
这块安全处理器会在显卡驱动加载之前,就从只读存储器完成启动初始化。原先存在漏洞的SEC2微控制器被直接移出设备初始化流程,过去破解手段依赖的攻击路径直接不复存在。
除更换安全处理器之外,固件安全防护还有多重加码。RTX50的固件采用RSA‑3K加密签名校验,只有经过官方验证的固件代码才能够正常执行。同时核心固件代码改用SPARK语言完成编写,这种编程语言在编译阶段就能够规避内存溢出类问题,从根源切断缓冲区溢出类攻击的实施条件。
性能定位不变,普通游戏体验不受影响
即便安全防护大幅升级,RTX50系列依旧保留产品定位划分。虽然新一代显卡原生AI算力相比上代产品有明显提升,但是在机器学习、大模型推理这类计算任务中,消费显卡的AI性能依旧被约束为专业级别产品的二分之一。
这套限制针对的只是AI计算相关的张量核心运算,对于普通游戏玩家来说几乎不会带来任何影响。显卡的游戏渲染性能不会被这套安全机制改变,日常游玩各类游戏的画面表现、运行帧率都维持原有水平,普通玩家几乎感知不到这部分底层改动。
这也意味着,想要靠购买新一代消费游戏显卡,再通过民间工具低成本拿到专业卡级别的AI算力,这个想法在RTX50平台已经行不通。想要完整释放全部AI计算实力,依旧只能选择厂商推出的专业计算产品线。
(智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。