一个关于香肠的问题,和四次重复的问答
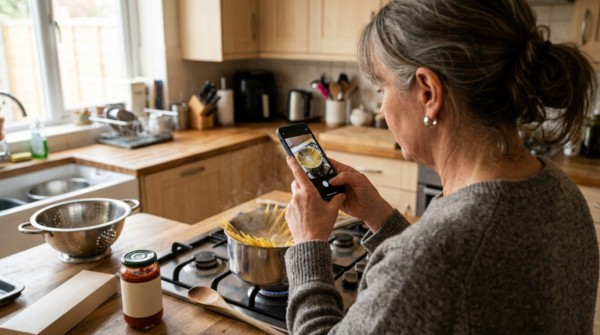
一位盲人用户把手机对准平底锅,问:“香肠变棕色了吗?”Be My AI的回答是,有些地方还有点粉。过了一会儿,他再拍一张,再问一次,前后问了大约四次,直到食物完全熟透。他后来告诉研究者,他真正想要的不是反复的问答,而是一句可操作的建议:“可能看起来还有点粉,再翻动一下,大概五分钟。”
这是马里兰大学(UMD)一项研究中的场景。研究团队招募了11名全盲参与者,让他们先在实验室熟悉Be My AI,再在日常生活中使用10天,最终分析了418次人机对话。研究论文题为《Say It My Way: Exploring Control in Conversational Visual Question Answering with Blind Users》,在2026年的ACM计算机系统人为因素会议上发表。
回答的长度,和问题的长度不在一个量级上
研究最直接的发现是一组失衡的数字。参与者提出的问题通常在10到20个词之间,而Be My AI的回答使用了超过10倍的词量。对话平均持续3轮,有些拖到了21个来回。
这些回答是朗读出来的,不是用来浏览的。听一段长回答、从中捕捉一个有用的细节、如果没抓到再问一遍,这个过程构成了盲人用户使用这类工具时的实际体验。研究合著者、UMD信息学院副教授Hernisa Kacorri的概括是:系统在生成描述上越来越好,但没有有效捕捉用户意图,这种能力往往转化为冗长的回答,而不是有用的答案。
问题的一部分是结构性的。Be My AI和许多同类辅助应用一样,每段对话都以一张完整的图片描述开场,而不是从用户提问的那个局部开始。超过一半的参与者将这一设计视为严重问题。一位只想找到钥匙的用户说:“它给了我一大堆我不想要的信息。”
用户被迫学会“反向操作”AI
研究更值得留意的部分,是盲人用户为了得到可用答案而发展出的策略。他们不是在被动承受长回答,而是在主动绕过系统的设计缺陷。
有人先解释自己为什么问这个问题,给AI提供目标背景。有人把复杂任务拆成更小的提问。一位检查面包面团的参与者,分别询问了大小、表面、气泡和面粉分布,并说这是确保答案正确的唯一方式。这些策略借鉴自通用AI工具的提示技巧,但UMD团队认为,这是首次系统性地记录这些技巧在辅助场景中对盲人用户如何起作用。
这些变通做法的存在,本身就是一个设计信号。论文作者之一、UMD信息学院博士生Yuehan Qiao的表述是:“我们仍然在要求盲人用户承担大量的解释工作。”在时间敏感的场景中,这种负担“不仅会延迟行动,还可能带来安全隐患”。
系统缺的不只是“短一点”的选项
论文摘要列出了Be My AI在交互层面的几项限制:缺乏对回答冗长度的控制,在估计空间距离和时间变化上能力有限,依赖对盲人用户不友好的图像取景方式,以及几乎不提供相机定位指导。这些限制指向同一个方向:系统被设计为一个“描述生成器”,而不是一个“意图响应器”。
两者的区别在香肠的例子中最为清楚。用户需要的是“接下来该怎么做”,系统给出的是“现在看起来怎么样”。当用户不得不通过四次拍照和四次追问来把前者从后者中提取出来时,交互的成本已经从AI转移到了用户身上。
研究团队的立场是明确的:盲人用户不应该为了得到简单答案而掌握复杂的提示技巧。视觉辅助AI要做到真正可访问,需要聚焦于用户需要知道什么,并交付清晰、有用的回答,而不是让用户去绕开技术本身的短板。
(素材来自:马里兰大学 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。