一场统一规则下的正面比较
过去几个月,OpenAI、Anthropic和Google都在向物理世界加码,招机器人人才、补真实世界数据、研发能控制机器人的模型。一个此前缺少实证回答的问题随之浮出水面:通用多模态大模型,能不能成为机器人的“默认大脑”。
10月20日,常态化具身智能仿真评测平台RoboColiseum给出了第一组正面交火的成绩。Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol和Gemini 4 Argon四款旗舰模型被放进同一套规则里,用统一的Agent2Act控制框架接入,接受相同的任务和原始指令,比较的是模型自身在机器人场景中的原生能力,而不是谁更擅长写提示词。
RoboColiseum由智元机器人发起,Hugging Face、英伟达、清华大学等高校、科研机构、开源社区和机器人企业联合共建,2026年8月正式上线。平台把评测拆成四个维度:指令跟随、空间推理、通用操作和鲁棒性。
总分:Opus险胜,差距小到可以忽略
四款模型的综合得分如下。Claude Opus 5.5以76.28分排在四款大模型的首位,GPT-6 Astra以75.99分紧随其后,两者相差0.29个百分点。GPT-6.1 Sol为70.91分,Gemini 4 Argon为66.86分。
但“四款大模型中的第一名”和“总榜第一名”是两个不同的概念。在RoboColiseum的完整榜单上,专用机器人策略模型Paimon以77.54分排在总榜首位,HiDream-O1-Embodied以76.92分位居第二,Opus 5.5的76.28分只能排在它们之后。通用大模型之间的竞争结果,暂时没有改变“专用模型仍守着头名”的格局。
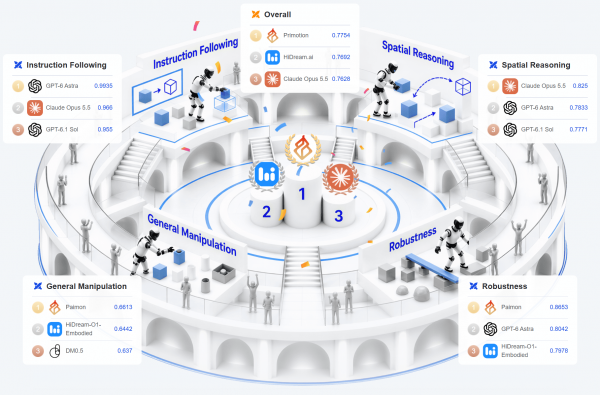
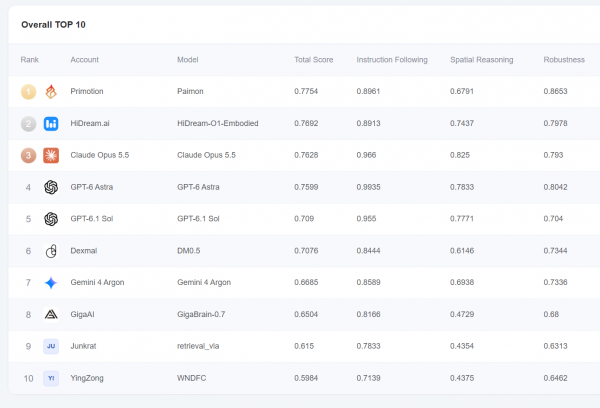
图片来自RoboColiseum官网
“理解”过关,“动手”不及格
这场评测最有价值的发现,是把能力边界拆到了可以比较的粒度上。在指令跟随和空间推理两个层面,四款大模型的表现明显占优。零样本入场、零任务微调,它们就能拿到66.86到76.28的综合评分,其中GPT-6 Astra的指令跟随得分达到99.35,接近满分。
但到了通用操作环节——抓取、开门、倾倒、分拣这些需要把动作做准做稳的任务——四款大模型的得分区间是38.79到46.70。同一批任务上,专用策略模型的得分区间是63.20到66.13。Opus 5.5在空间理解和通用操作上领跑四款大模型,Astra在指令跟随和扰动抵抗上最强,但这些局部的领先没有改变一个整体判断:旗舰大模型“理解”已经过关,“操作”这张卷子还没有及格。
新智元在报道中把这个现象概括为“眼高手低”:模型能在二维图像里准确圈出目标,但换到三维物理空间里,它不清楚锅必须端着两边才稳,抓取姿态可能像在拿一个烫手的山芋。
一个容易被忽略的弱点:图像质量
在补充的鲁棒性测试中,研究团队向视觉输入加入了噪点和镜头遮挡等扰动。Opus 5.5的得分降至76.47,GPT-6 Astra降至67.60,Gemini 4 Argon降至59.57,而GPT-6.1 Sol从70.91直接跌到18.36。
这组数字的意义不在于排出一个新的名次,而在于它指出了一个真机部署中无法回避的变量。实验室里的高保真渲染和真实摄像头采集的图像之间存在差距,光照变化、镜头污渍、压缩伪影都会让视觉输入的品质下降。一个在干净图像上表现稳定的模型,如果在轻微扰动下就失去判断力,那么它在物理世界中的可靠性就需要打一个折扣。
几个值得留意的结构性信号
Gemini 4 Argon在总分上垫底,但它在“抗扰动”这一项上超过了GPT-6.1 Sol,并且在包裹分拣这类长程任务上表现突出。Google此前的独立评测显示,Argon在ERQA具身推理基准上纯推理模式得分87%,在真机拾取放置任务上把完成时间从58.9秒压缩到17.4秒。这说明单一评测的总分只能捕捉能力的一个切面,模型在不同任务类型上的分布并不均匀。
商汤同期对GPT-6 Astra的实测则从另一个方向补充了参照。在RoboDojo仿真评测中,原本5次全失败的9个任务,在解除步数限制后变成了5次全成功。但代价并不低:叠碗任务平均耗时约131分钟,估算推理费用约19美元;把笔装进笔筒平均耗时263分钟,费用约55美元。能力上限被推高,和“用得起、等得起”之间,仍然隔着一段距离。
(素材来自:RoboColiseum 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。