决策模型和聊天模型,原本就是两种负载
理解Prism为什么存在,需要先看清它所服务的对象。聊天模型的任务是逐token生成文本,推理引擎的优化目标围绕“写得更快、更长、更连贯”展开。决策模型的任务则完全不同:读完一段材料,对有限个候选选项给出概率,输出的是A、B、C的选择、是或否的判断,或者给出一个风险分档的分数。
这个差别在通用引擎上会变成一个具体的浪费。以StartLux-Decision的27B模型为例,其词表约有24.8万个候选token,通用推理流程会为所有候选计算一遍输出层的分数;但一道决策题真正需要比较的,通常只有A到Z这几十个选项。同一份材料回答三个问题时,通用引擎会把每个问题拆成独立请求,分词、调度和公共上下文计算重复执行,处理时间随问题数线性增长。在H200上,vLLM(FP8)处理README中的三问题请求需要92.9ms,是单个问题的1.75倍。
Prism的起点,就是把这种“为生成而设计、用在决策上”的错配纠正过来。
四个改动,各解决一个具体的不匹配
Prism围绕决策任务的计算特征做了四项调整,每一项都对应通用引擎的一个具体低效环节。
第一项是收窄输出层。通用引擎为27B模型评分约24.8万个候选token,Prism把计算范围压缩到决策任务实际需要的字母选项,计算量降到原方案的约0.01%。
第二项是“森林式批处理”。共享的指令作为根,共享的参考材料作为树干,每个问题作为一根分支。同一份材料上的多个问题不再各自跑一遍完整的前向过程,公共部分只算一次。
第三项是INT8矩阵运算配合INT32累加。这一改动的作用不限于速度:它让输出结果不受批处理大小和调度顺序影响,相同请求在不同并发量和GPU配置下得到逐位一致的概率。对于需要复现问题、定位偏差的工程团队,确定性输出的价值不亚于吞吐提升。
第四项是混合调度器。最多64个较长的推理请求可以与直接作答的短请求共享同一块GPU,解码步骤预编译为CUDA Graph,新到的短请求只需等待一到两个步骤即可插入执行。
实测数据:加速幅度取决于“问几个问题”
StartLux公布的H200单卡测试结果给出了不同场景下的加速区间。短问题的单次请求从53.1ms降至19ms,约2.8倍;同一份材料回答三个问题时,从92.9ms降至17.4ms,达到5.3倍。在231道JevBench问题上,Prism平均每题41ms,vLLM为112.7ms,SGLang为75.6ms,llama.cpp为589ms。
部署方式的调整也会改变性能侧重点。四张H200数据并行模式下吞吐达到121请求/每秒,张量并行则将单题延迟压到29ms。短问题场景加速比较温和,多问题共享上下文的场景加速最明显,这与“森林式批处理”和“公共上下文只算一次”的设计逻辑一致。
量化精度方面,INT8版本的Prism在7个评测集、12351次决策上平均准确率92.94%,BF16原始精度为92.97%,差距0.03个百分点。一个16.55GB的压缩版本可以运行在单张32GB RTX 5090上。
需要说明的是,上述数字均来自StartLux自身的测试,测试配置已在代码仓库中公开,但尚未见到第三方独立复现的结果。
为什么这件事值得放在行业节奏里看
Prism发布的时间点紧邻DeepSeek开源DeepInfer。两家公司走的是不同路线:DeepInfer服务于通用大模型的云端大规模业务,Prism则聚焦决策模型这一细分负载。但它们指向同一个判断:推理效率的竞争正在从“模型本身”延伸到“模型与推理系统的协同”,通用推理框架在特定负载上的适配空间,开始被单独拿出来处理。
StartLux-Decision-v1.1于10月16日发布,以69.1分登上Hugging Face Decision Index 0.3.2榜首,在173个公开可复现模型中排名第一。在此之前,该模型运行在基于vLLM的通用框架上,Prism是其第一个为决策负载专门构建的推理引擎。代码于10月22日在GitHub发布,StartLux将其描述为首个面向决策模型、而非从聊天框架改造而来的开源推理引擎。
决策模型本身仍是一个年轻的品类,它的工程框架远未定型。Prism的价值不在于给出一个“通用引擎已经过时”的结论,而在于展示了一个更具体的事实:当负载足够特殊时,把推理引擎按负载特征重写一遍,可以释放出通用方案覆盖不到的效率空间。这个空间有多大,取决于后续是否有独立复现、以及决策模型在生产环境中的真实调用模式是否与StartLux的测试场景足够接近。
关于StartLux
StartLux(原点星辉)创始人兼CEO是陈大年,中国初代程序员和企业家。1999年,21岁的他与哥哥陈天桥共同创办盛大网络,2004年盛大登陆纳斯达克。2008年他创立盛大创新院并出任院长,从全国招募五百多位工程师探索新方向;WiFi万能钥匙即由该院孵化,到2016年6月全球用户突破9亿、月活5.2亿。陈大年同时是一位活跃的投资人,他作为最大出资人的基金是宇树科技(中国人形机器人领军企业)最早的天使投资人。
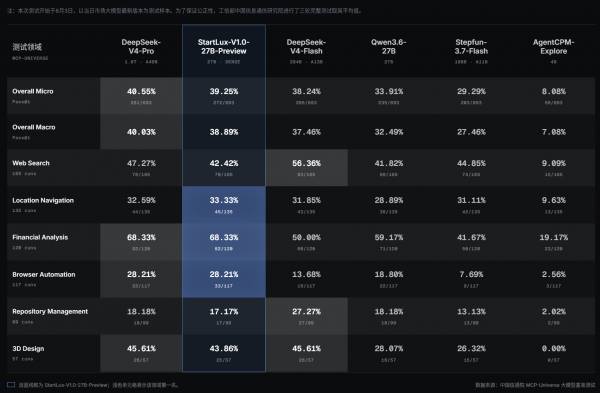
2026年,陈大年复出创立StartLux,选择的方向不是云端大模型,而是本地部署模型。他的判断是:大模型的智能水平已经够用,落地瓶颈在隐私、安全和成本;合同、聊天记录、企业know-how一旦上传云端,风险和token费用会同时阻止普通人“重用”AI。StartLux的第一款模型StartLux-V1.0-27B-Preview于2026年8月底发布,在工信部中国信通院MCP专项测试中以27B参数规模取得综合第二名,接近DeepSeek-V4-Pro的水平。公司成立约三个月即交出这一成绩,目前已开启首轮融资,中长期有上市计划。
(素材来自:StartLux 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。