

国产图生视频测评更新,多家头部模型同台竞技
随着AI生成视频技术快速迭代,市面上可供选择的图生视频工具越来越多。怎样客观衡量不同模型的实际水平,成为开发者和普通使用者都很关心的问题。SuperCLUE在10月23日更新I2V图生视频测评总榜,集中对多款主流国内外模型完成统一测试,直观展现当前行业的技术现状。
这份测评有着明确的排名规则。海外厂商的模型仅作为参照样本,不计入正式的国内榜单排名。为降低测试波动带来的干扰,测评还设置特殊判定标准,总分差距在1分以内的模型,会被认定为并列名次,避免微小误差改变最终排位。
国内综合头名诞生,应用维度表现突出
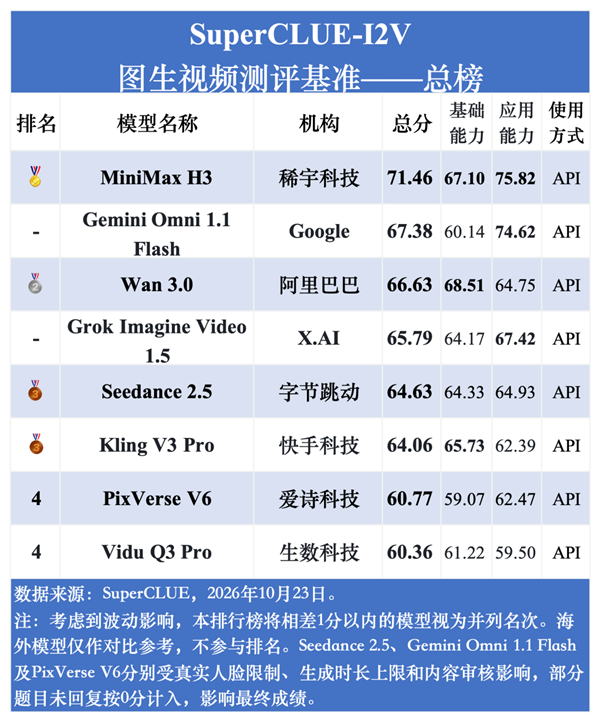
稀宇科技推出的MiniMaxH3拿到本次国内榜单综合第一,整体取得71.46的总分。测评将模型能力拆分为基础能力与应用能力两大板块,两套分数可以看出模型的不同偏向。它的基础能力得分为67.10,应用能力拿到75.82分,也是本次参评所有模型当中,应用能力单项得分最高的产品。
应用能力更多用来衡量模型贴合实际业务场景的表现,代表面对真实创作需求时的适配程度,这一项拿到高分,也意味着该模型在落地商用场景拥有不错的潜力。
国产梯队分布清晰,各模型能力各有长短
阿里的Wan3.0位列国内测评第二名,总分数达到66.63。这款模型的基础能力拿到68.51,该单项甚至超过榜首MiniMaxH3。但受限于应用能力仅64.75分,综合总分被拉开差距,也能看出不同产品研发侧重点存在明显分化。
第三名由两款模型并列获得,分别是字节跳动的Seedance 2.5与快手的Kling V3 Pro,得分依次为64.63、64.06。爱诗科技PixVerseV6和生数科技Vidu Q3 Pro成绩接近,二者共同排在国内第四名。
榜单当中还引入两款海外模型作为对比参考。Google Gemini Omni 1.1 Flash总分67.38,X.AI Grok Imagine Video 1.5取得65.79分,按照测评设定,以上两款不会参与国内正式排名。
部分客观因素会干扰最终测评分数
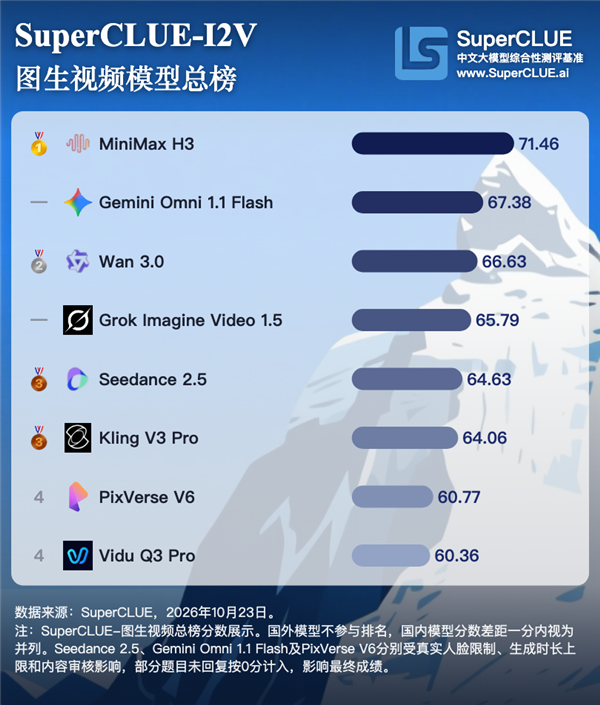
报告备注信息提到,有若干模型会受到外部条件约束,影响最终输出成绩。Seedance 2.5、Gemini Omni 1.1 Flash以及PixVerse V6都存在类似情况。真人出镜内容限制、单次生成时长上限、平台内容审核机制,都会造成部分测试题目无法返回有效结果。测评机制下未完成作答的题目直接计0分,会拉低模型整体的统计得分,并不完全等同于模型本身的真实上限。
理性看待跑分结果,实测体验才是关键
从整套测评数据不难看出,现阶段国产图生视频模型整体实力已经大幅度追赶海外同行,不少单项指标已经具备竞争实力。不过要分清,标准化基准测评跑分和真实使用体验之间不能直接划上等号。
测试集是一套固定命题环境,和现实里五花八门的用户创作需求并不完全重合。有些模型跑分很高,但面对个性化、复杂的创意指令,依旧会出现画面崩坏、逻辑出错等各类问题。
对于普通创作者以及企业用户,不能只盯着榜单分数挑选工具。不同模型擅长的风格、画面类型各有偏向。实际选型的时候,最好结合自身的业务场景,经过多组样片实测对比之后,再确定适合自己的图生视频方案。
(智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。