

推理框架开源,一组运营数据引爆行业讨论
不少大模型企业大多只会对外公布模型能力,很少公开真实的大规模推理运营指标。近期DeepSeek把自家内部使用的DeepInfer推理框架对外开源,同时放出一组真实集群运行数据,迅速在全球技术社区引发大范围讨论。
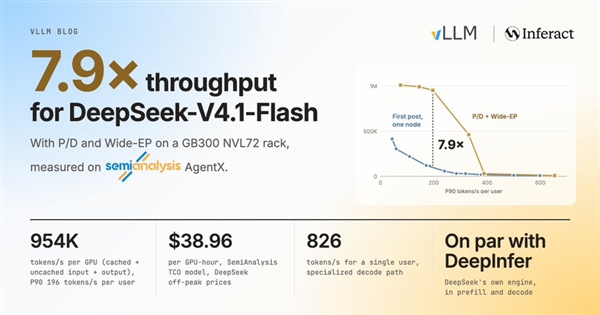
这套推理框架服务于DeepSeekV4.1Flash模型,主要目标是实现高吞吐同时压低响应延迟。官方披露,现有单集群每日可以完成155万亿Tokens的处理量,按照谷时段API定价来换算,平均单张显卡每小时对应的理论收入可以达到38美元。
这个数值一经公开,立刻吸引全球开发者关注。过去行业更多聚焦训练大模型需要投入多少资金,而这份材料把大众视线拉向推理环节,也就是模型对外提供服务这一环节的商业产出。
开源社区完成性能复现验证
一组数据是否可信,还需要外部项目做实际测试校验。vLLM、SGLang这类主流开源推理项目很快跟进适配,完成相关性能测试工作。实测结果证明,DeepInfer所实现的高吞吐能力具备现实可行性,部分优化版本跑出的指标甚至比原始公开数据还要出色。
从测试信息可以看到,在特定硬件机架环境下,优化之后的方案能够把处理效率提升数倍,在缓存命中的场景,单卡每秒可以处理海量Tokens。高缓存命中率是拿到高收入数据的重要前提,如果用户请求上下文重复度低,缓存无法生效,整体吞吐和收入都会出现明显下滑。
基于数据做出的算力收益推演
海外技术博主拿到验证结果之后,顺着公开数字做了一套理想化收益测算。按照单卡每小时38美元的基准,1GW规模的算力如果满负荷跑这套推理服务,一年理论可以拿到1500亿美元收入,就算把设备冗余、维护空置等现实因素纳入考量,预估年收入也能达到1000亿美元。
搭建1GW的AI算力集群,整体建设投入大致处在350‑500亿美元区间,选用AMD硬件平台整体成本会相对更低。参考这套理想化计算,项目回本周期会被压缩到很短,相关观点也提到一年回本属于相对保守的预估。
继续放大测算口径,如果每年新增50GW算力,假设一半算力资源投入推理业务,也就是25GW用于对外提供模型服务。沿用上面这套计费标准,就可以算出2.5万亿美元的理论营收,如果套用海外头部AI服务商的收费标准,推演数值会进一步来到10万亿美元级别。对比全球每年大约125万亿美元的GDP总量,该数值相当于全球GDP8%的规模。
理性看待推演,现实存在不少约束条件
需要明确,上面这套宏大的收益结果,全部建立在多个理想假设之上,并不能直接等同于行业即将实现的实际收入。
最核心一点,该测算默认全部算力都在运行DeepSeekV4.1Flash这套模型。现实当中海外AI企业大多会优先部署自家闭源大模型,不会把全部算力资源拿来运行第三方开源模型,这就从根源上限制推演场景落地的可能性。
除此之外,测算默认算力始终处于满负载运行状态。真实商业环境里,不可能每时每刻都有足够用户请求把显卡占满。市场需求总量存在上限,一旦大量新算力集中投产,市场供给变多,服务单价就会被向下拉动。当硬件运行开销超过服务带来的收入,这套高收益逻辑就不再成立。
给行业带来的现实启示
即便万亿级收入很难落地,这次开源事件依然具备很强参考价值。DeepInfer的公开,把大模型竞争从单纯比拼模型参数、跑分能力,延伸到推理调度、缓存优化、硬件利用率等系统工程层面。
同样的芯片与模型,推理框架好坏,会直接改变单位硬件能够承接的用户请求数量,进而左右单卡产出与企业利润。对于算力运营商、云服务商来说,推理软件优化已经变成降本增效不可忽视的一环。未来AI行业比拼的,不只是模型本身,还有整套软硬件协同调度的综合实力。
(素材来自:DeepSeek 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。