

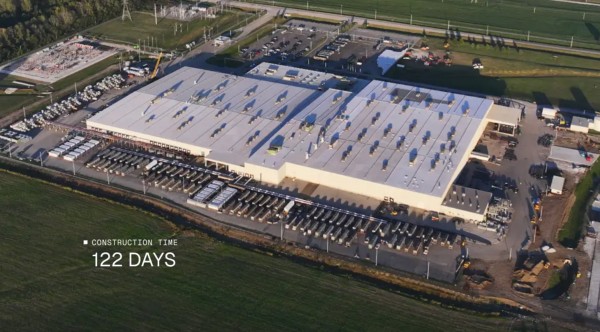
当地时间9月25日,马斯克在X平台上公布了Colossus 2数据中心的最新扩容时间表。这座位于田纳西州孟菲斯的AI超算集群,计划在2026年底前将GPU总量推高至约121万颗,较当前规模增加约120%。
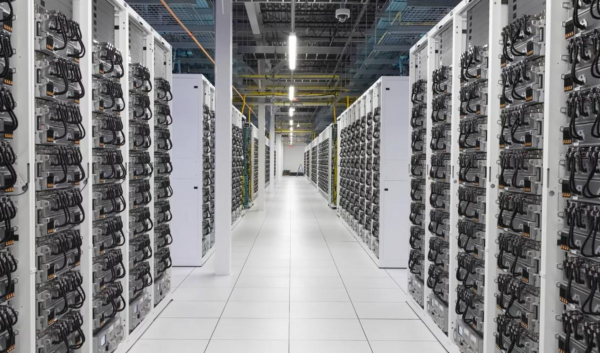
目前Colossus 2已部署11万颗英伟达GB200和44万颗GB300,合计55万颗GPU。扩容将分三批推进:首批22万颗GB300预计在公布后一周内全面投入运行,第二批22万颗将于11月上线,如果进展顺利,12月底前还将有最后22万颗GB300到位。三批合计66万颗GB300,使Colossus 2的GPU总数达到约121万颗。
加上Colossus 1现有的15万颗H100、5万颗H200和3万颗GB200,SpaceXAI在运营的GPU总数预计将达到约144万颗,其中仅GB300就将达到110万颗。据估算,这批GPU的总价值可能超过500亿美元。
Colossus 2全面转向Blackwell平台
与第一代Colossus混合使用Hopper和Blackwell架构不同,Colossus 2已全面转向英伟达Blackwell平台,新增部分几乎全部来自GB300。GB300是GB200的进阶版本,沿用Grace CPU,但GPU升级为Blackwell Ultra。
这一架构选择带来的是效率上的统一。Colossus 1因混合架构导致训练Grok时效率不高,已被整体租给Anthropic用于推理。Colossus 2专注于Blackwell,理论上可以避免类似的瓶颈问题。
电力自给:1.2吉瓦自备电厂
制约当前数据中心扩张的最大瓶颈之一是电力。Colossus 2的应对方式是自建发电设施。
据报道,SpaceXAI两座数据中心提供的算力超过2吉瓦,配套建设中的自备电厂容量达1.2吉瓦。这一策略使SpaceXAI成为全球首个算力突破1吉瓦门槛的AI训练集群。谷歌已签约使用其算力,付款额将在10月增至每月9.2亿美元。
但自备电厂也带来了争议。Colossus 2此前被曝在未获许可的情况下安装了59台天然气涡轮机,面临诉讼,公司随后承诺将其移除。
竞争格局:OpenAI Stargate的追赶
在AI基础设施竞赛中,Colossus 2目前处于领先位置。Epoch AI估计Colossus 2的IT电力约为946兆瓦,是目前全球最大的AI数据中心。
相比之下,OpenAI通过Stargate合资企业规划的美国容量约为7吉瓦,分布在七个站点,但当前运营的GPU数量估计仅为15万至20万颗,目标是在2026年底前提升至数十万颗。两家公司的路径差异明显:Stargate依赖合资和长期云租赁,Colossus 2则走自建、自持、自供电的重资产路线。
融资与公司重组
Colossus 2的扩张建立在庞大的资本运作之上。2024年5月,xAI完成60亿美元的B轮融资,创下当时VC史上最大单笔纪录。到2026年2月,SpaceX以约2500亿美元的估值将xAI合并入自身体系,合并后总估值达1.25万亿美元。
据报道,xAI正在进行一轮200亿美元的融资,包括75亿美元股权和125亿美元债务,通过特殊目的公司购买英伟达处理器,再出租给xAI使用五年。
值得留意的是,xAI的12名创始团队成员中,11位非马斯克联创已全部离职。公司正在从一家AI模型公司,转型为一家算力基础设施供应商。
一个尚未回答的问题
马斯克表示,SpaceXAI的AI业务仅发展3年,而Anthropic和OpenAI已分别运营6年和10年。他透露,未来两到三个月内有望推出达到Anthropic Fable和OpenAI GPT-6水平的模型,如果进步速度继续加快,约6个月后可以占据行业领跑位置。
但更大的GPU数量并不自动转化为更好的模型表现。Colossus 2的扩容时间表中,12月底前最后22万颗GB300能否到位,取决于硬件交付、冷却系统、网络配套和电力供应的同步推进。截至目前,这些新增GPU的实际运行效率和Grok系列模型的实际表现,仍是衡量Colossus 2价值的核心变量。
(素材来自:SpaceXAI 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。