

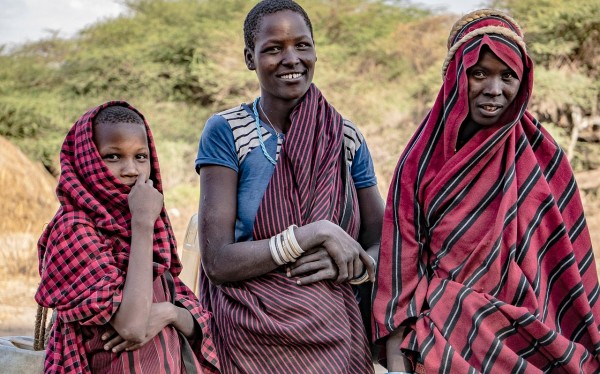
9月21日,纽约。盖茨基金会宣布了一项由60家机构共同签署的承诺,目标是在五年内,让约34亿使用“低资源语言”的人能够用自己的语言和声音使用AI工具。
签署方包括Anthropic、谷歌、亚马逊、微软、英伟达、OpenAI基金会,以及塞内加尔电信与数字事务部、联合国儿童基金会、世界银行集团、印度科学研究院、拉各斯商学院等政府、研究、慈善和社区组织。
这一名单横跨前沿AI实验室、科技公司、政府机构和草根语言组织。
一场关于“谁能用AI”的公平实验
全球约有7000种语言,但只有一小部分被认为拥有足够的数据、工具和评测基准来支撑可靠的AI能力。大多数语言在训练数据中几乎缺席。
盖茨基金会首席执行官马克·苏兹曼在接受美联社采访时给出了一个具体的例子:如果训练数据不具代表性,一个马拉维孕妇说“我的羊水破了”,模型可能将其直译成“她倒掉了水”——这种错误在医疗场景中可能造成严重后果。
“互联网不是一个具有代表性的空间,”Mozilla数据集体首席执行官E.M.刘易斯-琼说,“为什么你会认为,从一个主要由Reddit训练出来的系统里,能得到一个文化多元且有代表性的结果?”
刘易斯-琼提到的“原罪”指向一个现实:早期大语言模型超过90%的训练数据来自英语来源。这意味着,数十亿人的语言和文化语境,从一开始就不在模型的“视野”之内。
四个工作方向,一个共同目标
这份承诺并非发布一个新模型或一个统一数据集,而是划定了四个协同推进的方向。
第一,建设开放许可的语言数据基础设施。这意味着一套共享的、安全的数据底层,任何构建者都可以基于开放许可证使用。
第二,建立诚实的进展度量。开发评估与基准,衡量真实进展,而非笼统地宣称“支持了多少种语言”。
第三,把语言资源转化为可用的工具。让模型和应用不仅服务于资源最充裕的构建者,也能被更广泛的开发者使用。
第四,确保隐私、知情同意和数据主权贯穿始终。参与社区应当对自己的语言数据拥有控制权,而不是被从网络上“抓取”后失去话语权。
这四个方向之间存在清晰的逻辑链条:没有数据基础设施,就没有可用的工具;没有诚实的评测,就无法知道差距是否真正缩小;没有数据主权,语言社区就可能在被“代表”的过程中再次被边缘化。
谷歌的Project Vaani与非洲的语言行动
承诺的落地已经在推进中。谷歌正在资助一项名为Project Vaani的计划,在印度每个地区收集超过15万小时的音频数据。
谷歌高级副总裁詹姆斯·马尼卡指出,语音数据收集需要关注语言内部的方言差异,团队正在与当地伙伴合作进行实地录音。
在非洲,盖茨基金会支持的“非洲之声”项目已编译了9000小时的音频记录,覆盖肯尼亚、尼日利亚和南非的语言。非洲大陆有超过2000种语言,绝大多数因数据严重短缺而被排除在技术革命之外。
这个项目聚焦于三个伙伴国家的18种语言,由盖茨基金会提供220万美元资助,数据以开放获取形式发布,供任何人构建语言模型、语音转文字工具或翻译服务。
在更早的时间线上,Anthropic与盖茨基金会已于5月建立了2亿美元的合作伙伴关系,开放了数十种非洲语言的数据集——这些语言在主流前沿模型中的表现历来不佳。
速度之争中的另一种速度
这份承诺发布的时间点耐人寻味。就在同一个月,Anthropic首席执行官达里奥·阿莫代伊发表了呼吁行业“限速”的长文,OpenAI首席执行官奥尔特曼也表态支持控制前沿模型的发展节奏。
苏兹曼对此的回应直接而务实:“即使AI现在被冻结——我不期待也不会呼吁这样做——我们仍然希望构建这些语言数据集,并用现有的工具让它们变得可用。”
换句话说,语言数据的建设不应该被“是否放缓前沿模型开发”的争论所绑架。无论模型迭代的速度如何,语言鸿沟都需要被填补。政府需要监管AI对网络安全和儿童发展的影响,同时也需要将AI的人道主义应用扩展到那些目前被“拒之门外”的贫困社区。
(素材来自:盖茨基金会 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。