

连续21周领先,中国模型调用量达美国4.7倍
OpenRouter最新一周(9月14日至20日)的数据显示,全球AI大模型总调用量为129万亿Token,环比增长1.57%。其中,中国AI大模型周调用量达到67.46万亿Token,环比增长10.28%;同期美国AI大模型周调用量为14.21万亿Token,环比下滑34.7%。
这意味着中国模型的周调用量已达到美国模型的约4.7倍,连续第21周在该平台上占据领先地位。
OpenRouter是全球最大的AI模型API聚合平台,其调用量数据主要反映开发者和中小团队通过API的真实付费请求,被视为观察全球AI模型实际使用趋势的重要窗口。
前五占四席,DeepSeek新模型单周暴涨219%
上周调用量排名前五的模型中,有四款来自中国。
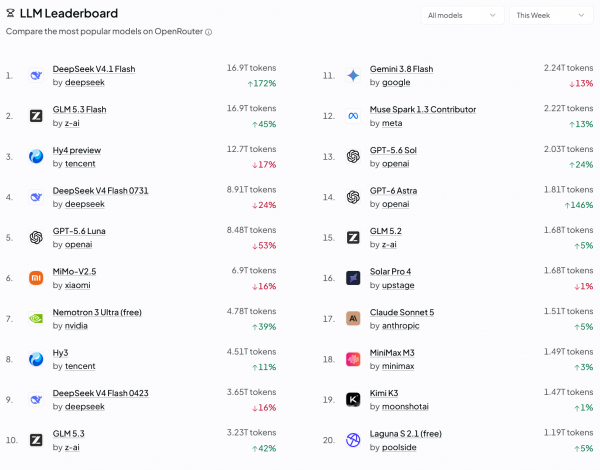
排名第一的是DeepSeek V4.1-Flash,周调用量达15.8万亿Token,环比暴涨219%。该模型于9月10日正式发布,在编程与Agent能力提升的同时强化了多模态理解能力。其采用的Causal-Encoder-Decoder新架构,将全局KV Cache降至前代的约四分之一,为推理降本释放了空间。
价格是它冲上榜首的重要推力。V4.1-Flash闲时每百万Token的输入缓存命中、未命中输入及输出价格分别为0.02元、1元和4元,较前代分别下降60%、33.3%和11.1%。
智谱GLM-5.3-Flash以14.1万亿Token位居第二,环比增长18%;腾讯混元Hy4 preview以12.5万亿Token排名第三,环比下滑26%;DeepSeek-V4-Flash-0731以9.44万亿Token位列第五。
值得注意的是,DeepSeek新老两代模型同时挤进前五,说明不少开发者在生产环境中换模型的速度比预期更慢,稳定性和兼容性往往比新功能更重要。
一年之间,格局彻底翻转
这一格局与一年前形成鲜明对比。去年9月,美国模型在OpenRouter上的token消耗占比约为80%,中国模型仅占约20%。到2026年8月,两者占比已彻底反转:中国模型的token消耗量占比超过60%,美国模型降至40%以下。
在公开可见的调用量前十榜单中,中国模型占据至少7席,合计占比超过70%。从厂商维度看,DeepSeek已升至平台厂商排名第一的位置。
中国模型的快速崛起并非单一因素所致。分析普遍认为,价格优势是核心驱动力。中国模型的公开API价格普遍为海外同级产品的10%至20%,在模型性能差距不断缩小的背景下,越来越多的开发者在高价值任务中使用顶级模型,而在其余场景中优先考虑价格和速度。
一个具体案例是:加密货币交易所Coinbase通过内部AI网关采用智谱GLM-5.2和月之暗面Kimi K2.7作为工程师默认工具,结合模型切换、智能路由和缓存优化,将AI成本削减了近一半。旧金山AI初创公司Lindy从Claude切换至DeepSeek-V4后,API支出从超过全部人力成本降至可控水平。
领先的背后,仍需看清数据边界
需要说明的是,OpenRouter的数据仅反映通过该平台产生的API调用,不包括各模型厂商自有API和云服务渠道的用量。因此,它反映的是对价格高度敏感的开发者和中小团队的选择倾向,而非全球AI大模型使用的全貌。
在技术层面,中国模型尚未在整体能力上超越美国前沿模型。主要评估机构的智能指数前五名仍由美国模型占据,中国模型目前的最好成绩在第七至第九位之间。差距在缩小,但绝对优势尚未建立。
从更宏观的视角看,OpenRouter上的调用量变化揭示的是一种结构性趋势:在性能差距逐步收窄的区间内,成本正在成为决定开发者选择的关键变量。中国开源模型凭借价格、迭代速度和开源生态的协同效应,正在全球AI应用层占据越来越大的份额。
(素材来自:OpenRouter 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。