

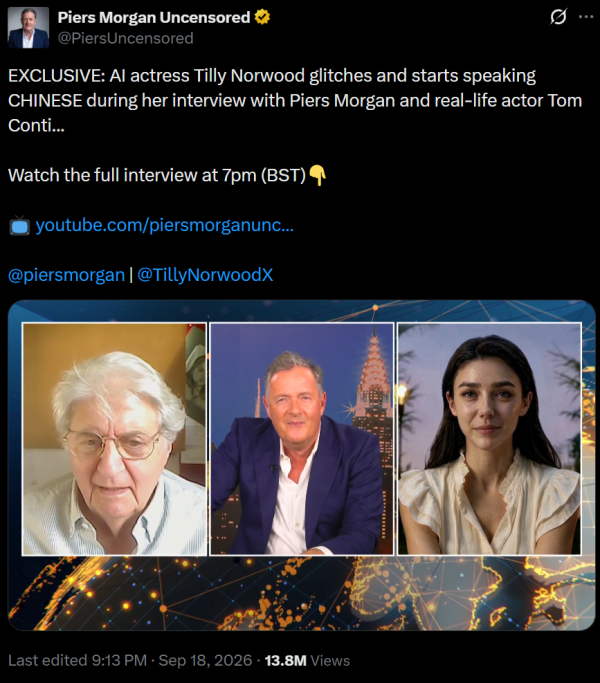
近日,英国知名主持人皮尔斯·摩根的访谈节目出现极具话题性的技术名场面。由英国Particle 6(6号粒子)公司研发的AI虚拟演员提丽·诺伍德(Tilly Norwood),在全程英文交流的访谈环节中,毫无征兆地切换为粤语回应问题,突如其来的语种跳转,让现场主持人与真人嘉宾当场错愕。
根据节目曝光片段,整场访谈全程采用英文对话,无任何其他语种干扰。初期,提丽·诺伍德始终以流利英文配合互动,在嘉宾持续追问其参演影片的相关细节后,AI模型突然出现语种跳转,完整输出一段粤语内容。
在现场人员的疑惑追问下,这名AI虚拟演员重新切回英文模式,主动解释自身出现异常,称系统出现轻微线路串线,属于临时的运行小状况。
视频全网爆火,官方回应引发全网争议
这段充满悬念的访谈片段迅速在海外社交平台发酵。截至9月20日下午,主持人摩根发布在社交平台X的相关视频,播放量已突破1380万次,大量海外网友聚焦核心疑问:为何英国本土研发的AI模型,在纯英文交互场景中会自主输出粤语内容。
针对全网热议的异常现象,福布斯等海外主流媒体跟进采访研发团队,获取官方解释。Particle 6公司对外表示,此次语种切换并非系统故障,而是模型多语言能力的直观体现。官方解读称,AI大概率捕捉到对话中近似粤语的发音特征,从而自动触发语种切换机制。
这套官方说辞并未获得网友认可。大量网友提出质疑,完整回看访谈全程,现场仅存在英文对话,并未出现任何粤语发音、词汇或语境线索,官方的解释无法贴合现场实际情况,说服力不足。
行业拆解深层原因,中文数据成核心推理枢纽
结合AI行业发展现状与学术研究成果,业内人士给出了更贴合技术逻辑的深度解读。影视AI技术发展进程中,国内是最早规模化推进AI影视生产、虚拟演员落地的地区之一,积累了海量高密度、高质量的中文行业数据与训练资料。
这些优质数据持续汇入全球AI训练数据库,成为海外大模型迭代学习的重要素材。提丽·诺伍德依托的大模型未做严格语种锁定设置,当遇到影视行业相关专业提问时,模型调取了训练库中的中文数据资源,最终出现英文场景输出粤语的异常现象。
多项权威学术研究,早已印证这一行业底层规律。近年多篇AI领域论文明确指出,全球主流大语言模型存在固定的“推理枢纽语言”特征。无论接收何种语种的输入指令,模型内部核心推理、逻辑运算,大多仅依托英语、中文两大语种完成。
研究团队针对15类输入语言、7个难度等级、18个学科领域开展全面测试,最终证实,中英双语之所以成为模型核心推理语言,核心原因是两类语言的高质量训练数据体量遥遥领先,其他语种缺乏充足的推理轨迹支撑。这也导致模型出现运算错乱时,只会跳转至英语或中文输出。
行业普遍存在同类现象,凸显数据全球化影响力
事实上,海外顶尖AI模型出现中文推理、中文输出的异常情况早已多次出现。此前OpenAI、Anthropic等头部企业的大模型,均被曝光过内部推理链条使用中文运算的案例。
其中Anthropic的相关现象曾引发广泛讨论,该企业长期倡导技术壁垒建设,但其模型的核心推理环节,却深度依赖中文数据体系,直观体现出中文数据在全球AI产业中的核心地位。
此次英国AI虚拟演员粤语输出事件,看似是偶然的程序小异常,实则是行业必然现象。高密度、高质量的中文数据资源,已经深度融入全球AI底层体系,成为支撑海外大模型迭代、推理、运行的核心基石,实现了跨地域、跨平台的技术渗透。
技术无边界,数据融合成AI发展核心趋势
业内分析表示,AI模型的语种错乱现象,成因是多维度的模型机制、数据训练、算法逻辑共同作用的结果,无法单一归因。但不可否认的是,持续积累的中文优质数据,是推动全球AI技术迭代、打破地域技术壁垒的关键力量。
人工智能技术的本质是全球化、共享化的数字科技,数据与技术的互通融合是行业发展的必然趋势。人为设置技术壁垒、割裂全球产业协作,违背AI技术的发展规律。唯有全球协同、数据互通、技术共享,才能推动人工智能产业持续良性发展,打造普惠全行业、全人类的智能生态。
本文由智算芯能前沿网编辑整理,转载请注明出处。