

8月20日,一个代号为Ox Alpha的模型悄然出现在OpenRouter和OpenCode平台上。没有厂商署名,没有官方公告,只有一行简短的描述。它提供100万token的多模态上下文窗口、13.1万token的输出上限,以及连续一周每天100万亿token的免费处理能力。社区给它起了个中文昵称——“牛来”。
随后的几天里,开发者们疯狂涌入。仅Hermes Agent、Claude Code等前五大应用对其累计调用就超过4万亿token,模型上线首日即登顶平台调用量榜首。关于它来自哪里的猜测满天飞:有人根据技术指纹认为它属于智谱GLM系列,也有人根据谷歌DeepMind研究员的暗示猜测它可能是Gemini新版。
谜底在8月26日晚正式揭晓。智谱宣布,Ox Alpha正是其新模型GLM-5.3 Flash的匿名预览版。智谱在官方博客中表示:“正式发布前,我们以Ox Alpha为名在OpenCode和OpenRouter上进行匿名测试以收集用户反馈。它迅速成为当周最受欢迎的模型——所有流量均由国产AI芯片承载。”
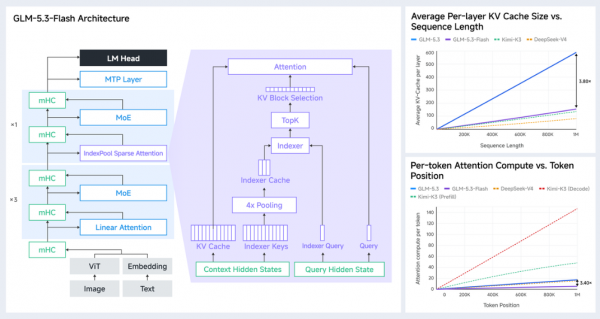
GLM-5.3 Flash是GLM-5系列的首个原生多模态模型,总参数量320B,实际激活参数仅18B。它采用MoE混合专家架构,45层结构,混合了线性注意力与稀疏注意力机制。与同代小尺寸模型往往蒸馏自大模型不同,GLM-5.3 Flash采用了与GLM-5.3不同的独立架构设计,并非简单的大模型剪枝版本。模型原生支持文本、图像和视频输入,拥有100万token的上下文窗口。
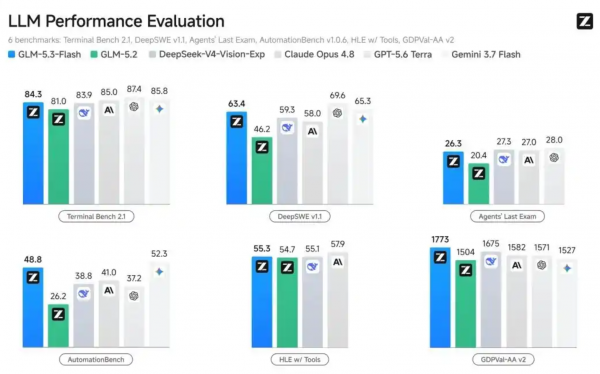
性能方面,GLM-5.3 Flash在Artificial Analysis Intelligence Index中取得57分,超过上一代旗舰GLM-5.2,与Anthropic的Claude Opus 4.8持平。在智谱自研的Z.ai Code Bench体感评估中,其编程表现也与Claude Opus 4.8相当。在Terminal-Bench 2.1上,GLM-5.3 Flash拿到84.3分,DeepSeek-V4-Flash为82.7分;在DeepSWE上则是63.4对54.4,领先9分。值得注意的是,DeepSeek-V4-Flash的54.4分是在自家Harness极简模式下跑出的,而GLM-5.3 Flash的63.4分是纯模型裸测。
定价策略是这款模型最具有冲击力的部分。GLM-5.3 Flash定价为GLM-5.3的十分之一——每百万token输入0.8元、输出2.8元、缓存命中0.23元。上线前两周实行半价优惠,限时折扣期内价格进一步降至GLM-5.3的二十分之一。与Claude Opus 4.8相比,价格约为其四十分之一。横向对比调价后的DeepSeek V4 Flash,其谷时价格分别为输入1.5元、输出4.5元。综合输入和输出成本,GLM-5.3 Flash在绝大多数常规调用场景下都更便宜。
更值得关注的是算力层面的突破。智谱确认,GLM-5.3 Flash的推理服务全部跑在国产芯片集群上。据相关报道,智谱调用超过10万张国产芯片集群用于该模型推理服务,算力供应商或来自华为昇腾、摩尔线程与海光。智谱在技术文档中表示,其集群“硬件效率及单位token成本已经达到了与主流英伟达GPU相当的水平”。匿名测试期间,用户并不知道模型背后是谁、使用什么芯片,只会根据速度、稳定性和效果决定是否继续调用——国产算力因此接受了一次持续的真实流量考验。
为了让前沿模型真正跑在国产芯片上,智谱对推理系统做了大量针对性改造。基于SGLang构建专用推理引擎,引入节点内张量并行、W8A8量化、INT8/FP8/BF16混合缓存量化等技术。在集群层面采用Encode-Prefill-Decode分离架构,将多模态编码、Prompt预填充和逐Token解码拆分为三个可独立调度的工作池。与同一批硬件上的初始基线相比,这套方案将端到端服务性能提高了3倍。
从行业视角来看,GLM-5.3 Flash的发布至少释放了两个信号。第一,轻量级旗舰模型正在成为市场主流——兼顾性能与低成本的模型定位,正随着企业AI调用量暴涨而获得越来越大的市场空间。第二,国产大模型+国产算力的规模化落地可行性得到了验证——十万级国产卡集群跑通大模型推理,意味着国内算力基础设施迈出了重要一步。正如智谱在博客中所说,这是一款开源模型首次进入此前主要由高价闭源旗舰占据的能力区间。
模型权重已在MIT许可证下开源,开发者可通过智谱API及Cloudflare Workers AI等平台调用。半价优惠将持续至9月9日24时。
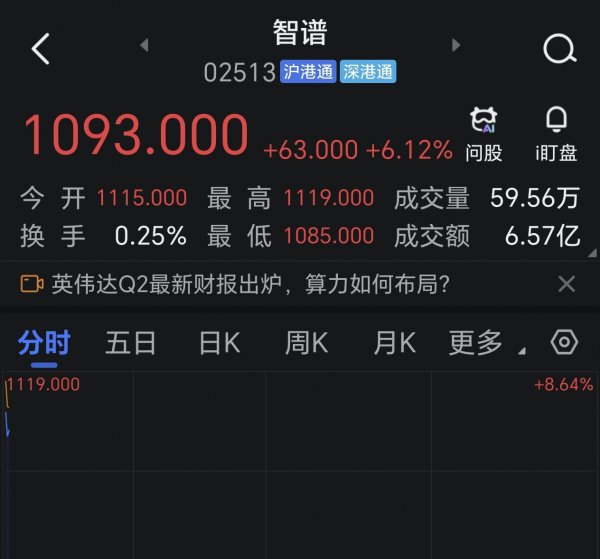
8月27日早盘,智谱(HK02513)跳空高开
( 素材来自: 智谱 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。