

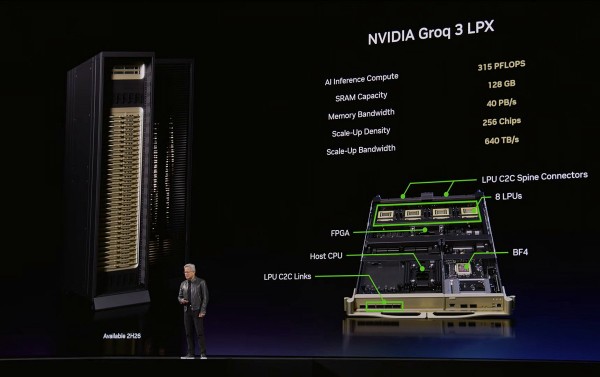
英伟达(NVIDIA)于8月24日表示,其Groq 3 LPX推理系统已与Vera Rubin NVL72平台一起进入全面生产。
在100000 token的Gemma 4 31B基准测试中,NVIDIA报告了每秒约输出3400个token;该结果适用于指定的供应商配置,而非每次部署。
该公告涉及NVIDIA的长上下文推理配置,而非针对每个模型或部署的通用性能结果。
NVIDIA的技术说明在引用基准中给出了更精确的中位数结果,即每秒3431个输出token,并表示对比使用了100000 token的输入上下文。
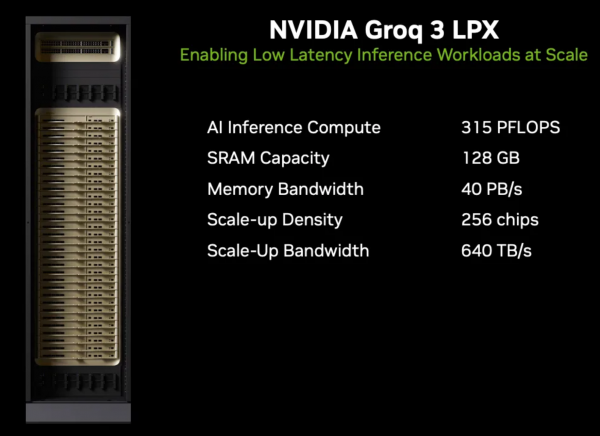
该配置将LPX系统与Vera Rubin NVL72相结合。NVIDIA将LPX机架描述为256个互连的本地处理单元,旨在优先考虑确定性token生成和推理工作负载的低延迟。
这些架构声称来自供应商,应被视为产品规格,而非独立的容量研究。
100000 token测试与保持大量上下文的工相关,例如代码代理和检索密集型系统。
(素材来自:NVIDIA 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。