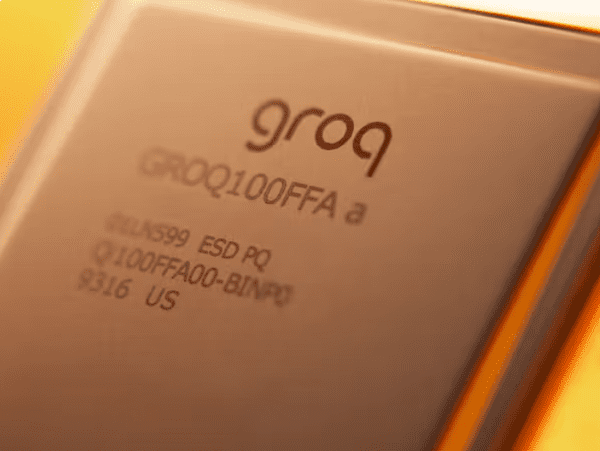
AI大模型的参数规模持续走高,对推理芯片的存储能力提出越来越苛刻的要求。半导体行业传来一则值得关注的行业消息,原本依靠片上SRAM实现超高推理速度的Groq,正在重新规划下一代芯片的存储架构路线,准备引入3D堆叠DRAM封装方案,以此解决老架构容量不足的现实难题。
Groq已经被英伟达完成实质性收购,这家企业的LPU芯片,过去在AI推理速度层面拥有非常亮眼的市场口碑。这套设计把SRAM直接集成在芯片内部,能够实现极高的数据读取带宽,在生成式AI的解码环节优势十分突出。但SRAM技术本身存在先天短板,读取速度虽快,存储密度却很低,很难做到更大容量,当芯片需要承载千亿级参数大模型时,单颗芯片就会遇到明显瓶颈,往往要依靠大量芯片集群拼接才能完成任务,拉高整体部署成本。
3DS堆叠内存的实现逻辑
按照行业知情人士透露的信息,Groq下一代产品将评估用DRAM来替代部分SRAM的设计思路,采用代号3DS的三维堆叠内存方案。传统AI芯片大多采用平面铺开的2D封装,而3D封装技术可以把多块内存裸片垂直向上叠放,类似搭建多层楼房,不再全部平铺在基板上。
这套方案的底层依靠TSV硅通孔工艺,会在DRAM晶圆上制作成千上万的微型垂直通孔,让上下堆叠的每一层内存裸片完成信号互通。这样的结构可以在不盲目扩大芯片整体面积的前提下,有效提升存储总容量,同时改善电力传输效率,兼顾硬件的功耗表现。
很多人会把3DS和大家熟知的HBM相互混淆,两者虽然都用到TSV堆叠工艺,但产品定位有很清晰的区分。HBM的设计核心是追求极致的数据传输带宽,主打高速吞吐,多用于AI训练场景。而3DS方案保留了DRAM原有标准接口,不盲目追逐带宽上限,把优化重心放在存储容量扩张上。对于需要一次性载入海量模型参数的推理任务来说,这是一套偏向务实的降本思路,也可以降低配套改造的工作量。
平衡速度与容量,解决推理落地现实痛点
从硬件特性来看,DRAM原生读写速度比不上SRAM,不过它的存储密度优势巨大,可以用更低的成本实现更大显存空间。Groq做出架构调整,并不是完全抛弃过去积累的推理速度优势,而是希望借助堆叠DRAM补足容量短板,改善单颗芯片处理超大模型的能力,不用再依靠大规模多卡集群才能跑通大参数模型。
在真实业务场景当中,不少AI推理业务既要保证响应速度,同时还需要吃下体积庞大的模型权重。旧的纯SRAM路线,想要装下完整大模型参数,必须把几十上百颗芯片组成整套机架,对于中小型部署场景不够友好。改用3DS堆叠DRAM之后,单芯片显存规模得到提升,部分业务场景可以减少芯片使用数量,降低机房部署的硬件投入。
推理赛道技术路线正在分化
这一次Groq架构的调整,也折射出整个AI推理芯片行业正在发生的路线分化。一部分厂商坚持走高带宽路线,一部分厂商持续挖掘片上高速缓存的潜力,还有不少企业开始尝试3D堆叠存储,把计算单元和内存裸片叠合到一起,用来调和速度、容量、成本三者之间的矛盾。
当然目前这套3DS堆叠DRAM方案还处在评估阶段,后续芯片的实际性能、功耗、成本表现,还需要等待正式硬件落地之后才能验证。但这一信号已经说明,随着大模型越做越大,只单纯追求芯片运算速度已经不够,存储架构的取舍,会直接决定AI芯片在真实业务环境里能不能大规模普及。如何平衡好读写速度与存储容量,会成为接下来推理芯片厂商需要持续攻克的核心课题。
本文由智算芯能前沿网编辑整理,转载请注明出处。