AI机架的功率密度和单柜算力仍在往上走,铜缆在机架内部承担PCIe信号传输的难度也随之增加。
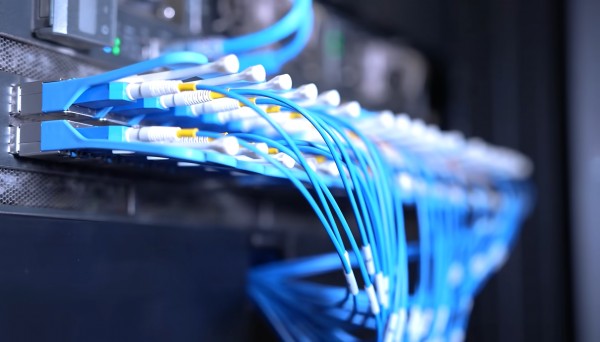
在2026年OCP全球峰会上,Lumentum、Astera Labs与Corning联合展示了一套机架级的概念验证,尝试用光纤把PCIe信号送到铜缆难以覆盖的距离,从而给GPU、交换机和内存的物理布局留出更多余地。
铜缆的物理边界正在收窄
PCIe本身是一套连接加速器、交换芯片、内存和存储设备的成熟架构。问题不在协议,而在电气通道的传输距离。Corning光通信商业技术经理Joshua Fennimore给出的对比是:被动铜缆通常只能覆盖几米的范围,主动铜缆可以延伸一些,但光纤在数据中心内可以跨越数十到数百米。
随着PCIe数据速率继续提升,电气链路对损耗、串扰和均衡的要求会变得更苛刻。设计人员要么增加retimer,要么把相连设备摆得更近;而高速铜缆的线径和体积又会给布线和管理带来额外负担。对于功率密度已经很高的AI机架来说,这些约束会直接压缩机柜内部的空间安排。
OCP演示里实际跑了什么
三家公司的演示组合是:Astera Labs的Scorpio Smart Fabric Switch、Lumentum基于1060nm VCSEL的光互连平台,以及Corning的多模光纤。链路使用了多条32Gb/s NRZ光通道,并实现了一条无误码的PCIe 5连接。
Lumentum产品与战略营销高级总监Christian Urricariet明确表示,这是一次概念验证,不是产品发布;光学PCIe不会消除全部系统限制,但可以把一部分限制从“电气距离”转移到“光链路预算”上来缓解。
机架和机列的设计假设会被松动
光学PCIe最直接的价值不是把每一根铜缆换掉,而是改变了基础设施可以放在哪里。Fennimore指出,铜缆的有限距离往往迫使交换机和计算硬件物理上紧挨在一起;光纤则允许这些系统跨机架、甚至跨机列分布,让运营商围绕计算密度、供电、散热、可维护性和线缆管理来重新安排布局。
Astera Labs信号连接事业部产品营销高级总监Jignesh Shah进一步说明,当传输距离达到数十米时,面向多机架的扩展架构以及为GPU、交换机和内存分别设置专用机架的分散式设计都变得可行。
对系统架构师来说,这意味着机架不再必须是一个把所有东西塞进去的封闭单元。功率分配和散热限制可以在机列层面重新权衡,可维护性也不必再被铜缆长度绑死在同一块物理空间里。
PCIe标准层面已经在为光学铺路
光学PCIe不只是几家公司的实验方向。PCI-SIG已经通过Optical Aware Retimer工程变更通知,在PCIe 6.4和PCIe 7.0规范中引入了标准化的光学互连路径,使符合规范的交换机、根复合体和端点芯片能够以光学方式衔接。
与此同时,更激进的共封装光学路线也在推进:Ayar Labs与Wiwynn合作展示的TeraPHY光引擎和SuperNova外部光源已经进入机架级系统验证,Lightmatter则在OCP上展出了204.8Tbps的CPO交换机托盘和102.4Tbps的XPU托盘。
这些方案与光学PCIe处在不同的技术层级上,但指向同一个方向:把高速信号的传输介质从铜逐步转向光,为机架级系统集成腾出物理空间。
铜缆不会退场,3米是一道实际的分界线
铜缆在短距离内仍然是更成熟、总体拥有成本更低的选择。Shah给出的判断是,一旦设计需求超过约3米,就是同时评估铜缆和光学方案的合理节点;在几米范围内,铜缆目前仍能提供最佳的TCO。
客户最终权衡的变量集中在功耗、密度和延迟上:光学方案可以支持更高密度和更低延迟,但铜缆的成熟度和供应链规模在短距场景中很难被替代。
Urricariet也强调,目标不是让每一条PCIe连接都变成光纤,而是随着AI机架规模和复杂度的增长,扩大系统架构的可选范围。
从一次OCP演示到大规模部署,还需要在系统集成、可靠性、制造和客户认证上继续推进。但光学PCIe已经把一个此前被铜缆物理性质固定住的设计变量摆上了台面:当PCIe信号可以走得更远,AI机架的排列方式将迎来前所未有的改变。
(素材来自:OCP全球峰会 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。