

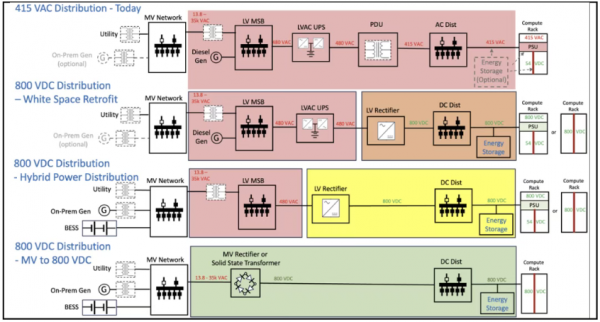
当行业目光持续聚焦 GPU、HBM 与液冷技术,很多人容易忽略一个底层约束:电力架构,正在成为下一代 MW 级 AI 机架规模化落地的核心瓶颈。随着单台 GPU 机架功率从几十千瓦持续攀升至数百千瓦,甚至迈向兆瓦级别,传统低压大电流的机房供电方案,已经暴露线缆损耗大、铜材耗材多、转换环节冗长等短板。一场围绕 800V 高压直流、分布式储能、DC 母线槽的电力体系重构,正在 AIDC 行业悄然推进,技术远期目标直指 1500V DC。
GPU 功率的增长曲线,直观印证了这场变革的必要性。从 Ampere 时代约 10kW,到 Hopper 的 40kW,Blackwell 达到 120kW,Blackwell Ultra 为 150kW,下一代 Rubin 突破 200kW+,Rubin Ultra 甚至冲击 1000kW+。算力硬件的功率暴涨,早已不是简单更换服务器电源就能应对,需要从服务器、机架、机房直至电网接入端,对整套电力系统重新设计。800V DC 方案,就是这套重构思路里的核心路径。
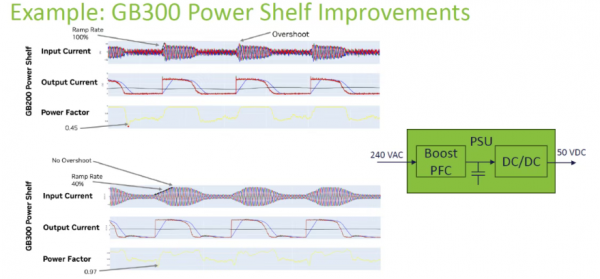
800V 高压直流的核心逻辑,依靠抬升配电电压来降低传输电流,精简电能变换层级。目前行业存在两条 MGX 机架技术路线:传统方案是 800V DC 先送入 Power Shelf,再输出 54V 母线供给服务器;更前沿的 Direct-to-Node 方案,则把 800V 直流直接送到服务器节点,再逐级降压至 12V,最终供给 GPU,机架供电能力可突破 1500A。这意味着高压直流不再局限于机房配电间,而是持续下沉,直达 AI 机架内部,重新定义数据中心到 GPU 芯片之间电能转换的边界。
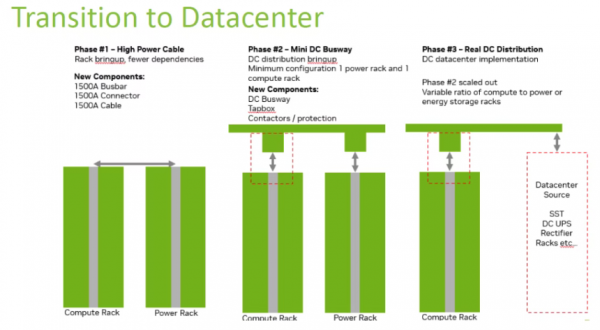
800V DC 的落地,也会经历循序渐进的三阶段演进。第一阶段优先解决高功率线缆、连接器与 1500A 母排的工程难题;第二阶段部署 Mini DC Busway,用直流母线槽串联多组算力机架;最终完成全机房级直流配电体系,实现从中压电网,借助固态变压器直接输出 800V 直流主干给算力集群。整体路径就是从单机架 800V,到行级 DC 母线槽,最终升级为全数据中心直流配电网络。
很多人误以为 AIDC 供电难题只在于峰值功率,实际更大的挑战来自 GPU 负载的剧烈瞬态波动。AI 任务启停会带来快速负载摆动,功率的急剧变化向上传导,会造成电压、电流剧烈震荡,冲击上游电源、UPS 甚至电网。这就凸显储能的价值,储能可以快速吞吐功率,平滑 GPU 带来的负荷波动,让电网侧只需要承接相对平稳的基础负荷。
行业也逐渐形成分层储能的设计思路,并非依靠单一锂电池包解决全部问题。板载电容应对微秒级瞬时冲击;机架级快速储能处理短时间功率突变;行级储能与机房 BESS 锂电池,承接秒级乃至更长周期的功率调节。储能的部署位置也有多种选择,放置在 GPU 近端,瞬态响应更快;放在机房入口侧,则更适合承担削峰、备用供电等功能。分层储能的布局设计,将成为高功率 AIDC 方案设计的关键一环。
当然,800V 直流距离大规模商用还有不少障碍。UL、IEC 相关认证体系仍在完善,直流电弧故障缺少成熟标准化模型,直流断路器故障保护难度高于交流。同时,超大电流场景下,线缆、连接器的散热压力陡增,液冷技术不再只服务芯片,还需要用于直流母排与供电线缆降温。
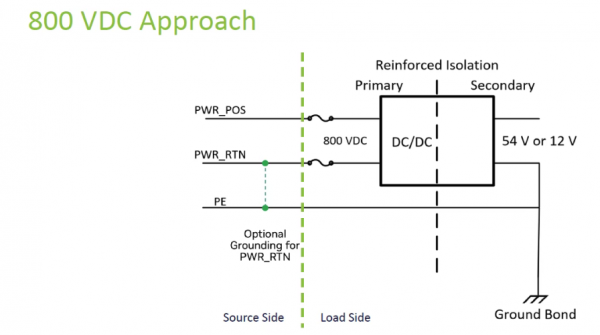
从产业视角来看,800V DC 不是单一设备的升级,而是整套算力电力底层范式的切换。它的架构设计预留了向 1500V DC 演进的空间,两线加接地的架构还能减少铜材消耗,降低设备体积。但整套方案的落地,需要设备厂商、云厂商、标准机构协同推进,安全规范、器件量产、工程验证缺一不可。
在 MW 级 AI 机架普及的趋势下,高压直流与分层储能的系统设计,该如何平衡安全规范、硬件成本与长期运行能效?
本文由智算芯能前沿网编辑整理,转载请注明出处。