

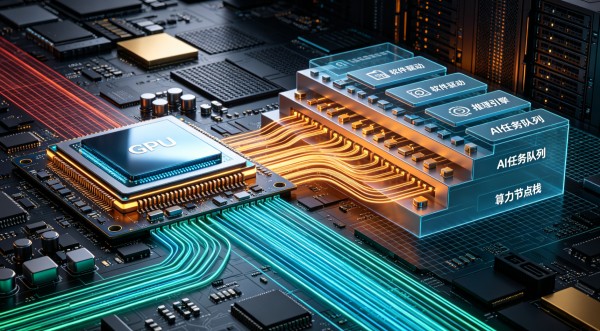
9月22日,龙芯中科正式发布支持自研通用GPU的龙芯加速计算平台(Loongson Accelerated Computing Platform)首个软件版本。
该平台基于龙芯2K3000及9A1000芯片内集成的自研LG200系列通用GPU核心打造,实现了从算力芯片驱动、算力编程环境到AI模型推理的全栈一体支持。
全栈组件,一站式开发
平台核心组件涵盖推理引擎、高性能算子库、专用编译器、运行时环境、调试工具及性能分析套件。
运行时环境提供资源调度管理、内存管理、任务队列调度和事件同步等功能;底层驱动对各类硬件计算资源进行统一抽象与管理,支持多进程、多任务并发执行。
编译器针对龙芯通用GPU的指令集架构和硬件特性进行了深度优化,并通过API层面的兼容来降低开发与迁移成本。
调试与分析工具支持断点设置、寄存器访问以及张量单元等硬件部件状态检查,可用于定位访存越界、计算异常和同步死锁等开发问题。
CUDA兼容,降低迁移门槛
平台同时支持OpenCL 3.0与CUDA两类主流编程模型接口。这意味着开发者可以将基于CUDA开发的AI应用以较低成本迁移至龙芯平台,大幅降低国产算力生态的迁移门槛。
算子库目前覆盖基础线性代数(BLAS)和神经网络(DNN)计算。BLAS算子针对FP32、INT8等数据类型的矩阵乘法、矩阵向量乘法和向量运算进行了汇编级优化;DNN算子则覆盖卷积、池化、归一化、全连接和激活函数等常用操作。
针对龙芯通用GPU的张量单元及缓存层次结构,龙芯中科还对算子库进行了专门优化,以提高硬件计算资源利用率。
LacInfer推理引擎释放硬件性能
AI推理是平台的核心能力。龙芯自研的高性能推理引擎LacInfer通过算子融合、常量折叠、算子消除和布局转换等方式优化计算图,可生成高度精简的计算图,充分释放GPU硬件性能。
其中,算子融合支持逐元素算子以及多分支、多输入算子的融合,也支持卷积、偏置和激活算子的深度融合,以减少数据访存。
平台完善支持ONNX Runtime,并将LacInfer作为ONNX Runtime的执行后端。用户可以将由PyTorch、TensorFlow等训练框架导出的ONNX模型直接部署到龙芯通用GPU平台,无需额外转换或重写代码。
目前,龙芯中科已在9A1000等芯片上针对目标检测、图像分割、姿态估计、旋转目标检测等计算机视觉模型进行了优化,在提高推理速度的同时,相关量化推理的精度损失也得到控制。
覆盖全系列芯片,面向多场景应用
硬件层面,该平台覆盖龙芯全系列算力芯片,支持Linux多内核版本系统,后续将与9A2000、9A3000等芯片同步演进,实现代际兼容。
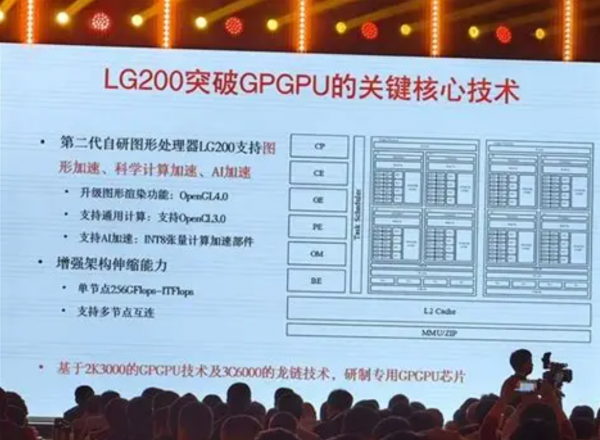
LG200系列GPU是龙芯第二代自研通用GPU核心,单精度浮点峰值性能为256 GFLOPS,8位定点峰值性能为8 TOPS,支持通用计算加速和AI加速。而基于LG210核心的9A1000芯片,AI推理算力达到40 TOPS,整机图形与计算综合性能较上一代提升超过五倍。
应用场景方面,该平台可服务于工业视觉、智能安防、智慧零售、车载感知等多个领域。目前已有部分早期客户基于2K3000及9A1000芯片开展具身智能设备的研制。
龙芯中科表示,相关算力软件已经服务部分早期客户,未来将随芯片代际推进持续演进。
(素材来自:龙芯中科 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。